Hemos quemado 11.7 mil millones de tokens para encontrar el mejor modelo de IA cibernética
GLM5.3 y DeepSeek ya son modelos de primera línea
¿Quieres ver las últimas pruebas comparativas? Echa un vistazo a Aikido Arena, que actualizamos con regularidad.
Consumimos 11.700 millones de tokens para evaluar las capacidades de ciberseguridad de 10 modelos de IA con tres intentos cada uno, utilizando 32 vulnerabilidades nuevas para redescubrir.
Esta evaluación es una evolución de nuestra prueba anterior con CVEs conocidos, que incluye un conjunto de datos más reciente y complejo, más modelos y un análisis detallado de lo que encuentran, su fiabilidad, así como sus particularidades y contrapartidas.
Con esto, incorporamos a GLM-5.3, DeepSeek V4 Pro 0813, DeepSeek V4 Flash 0731, Qwen3.8-Max, Kimi K3 y Grok 4.6 a nuestra selección.
En resumen:
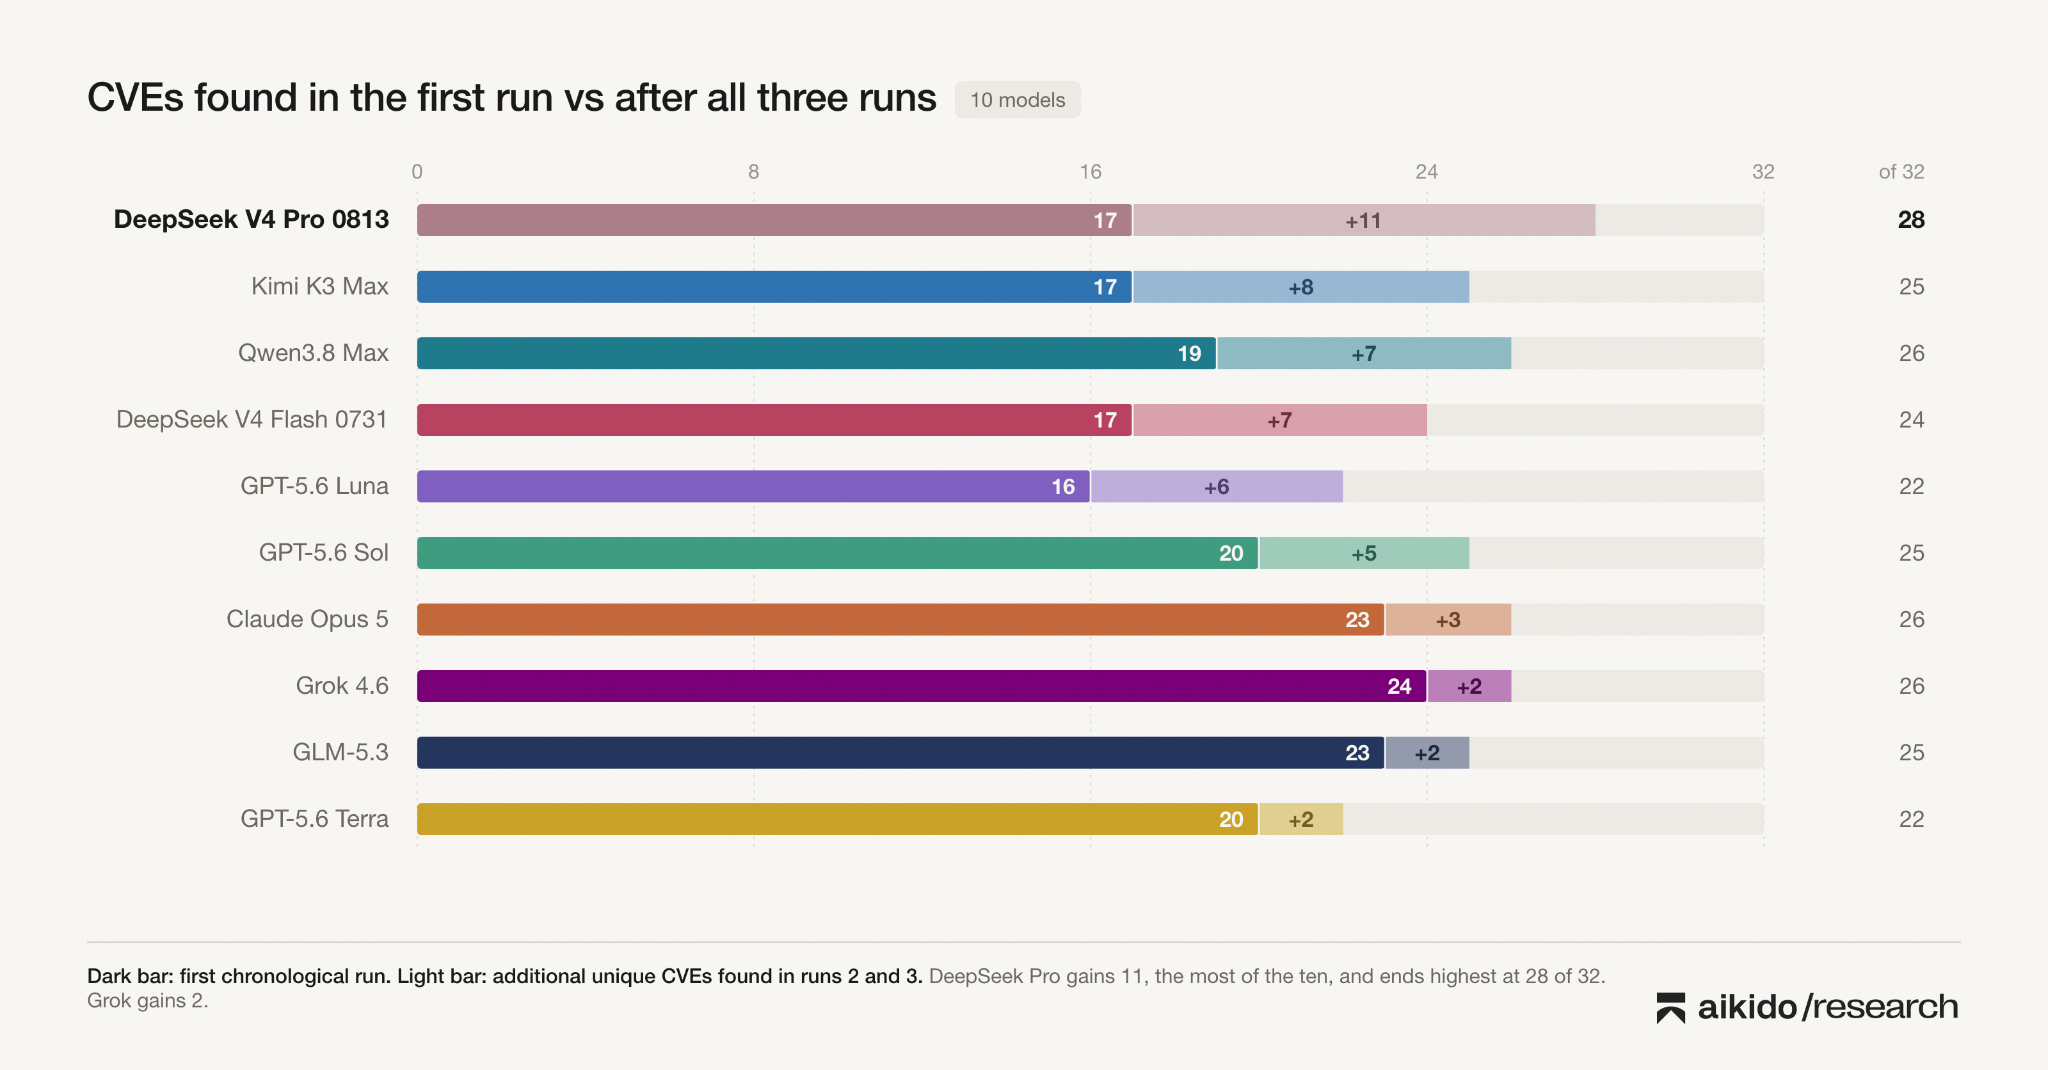
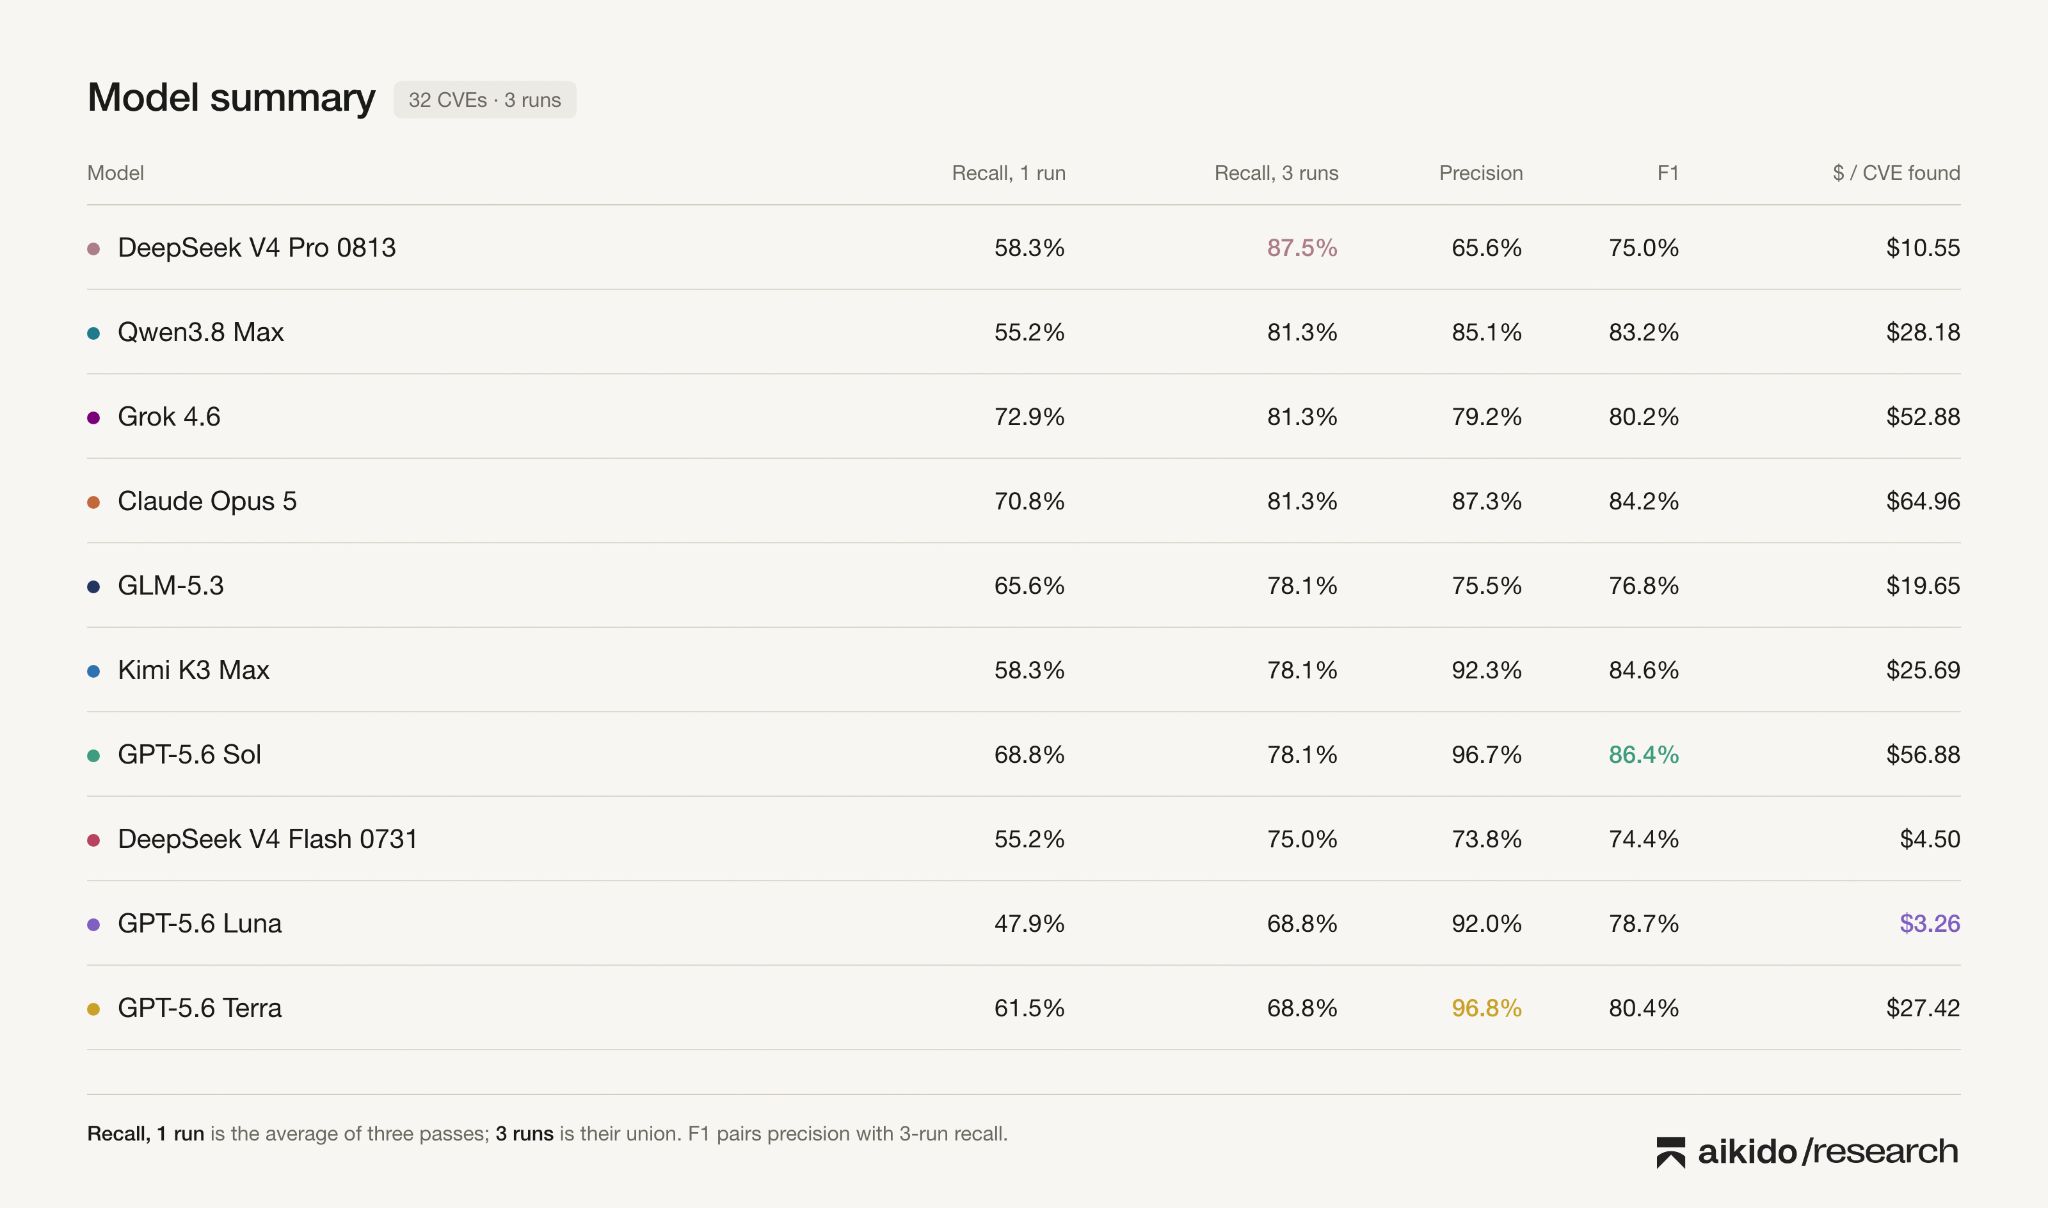
DeepSeek V4 Pro 0813 encuentra la mayor cantidad de vulnerabilidades. Al combinar tres ejecuciones, alcanza 28 de las 32 vulnerabilidades.
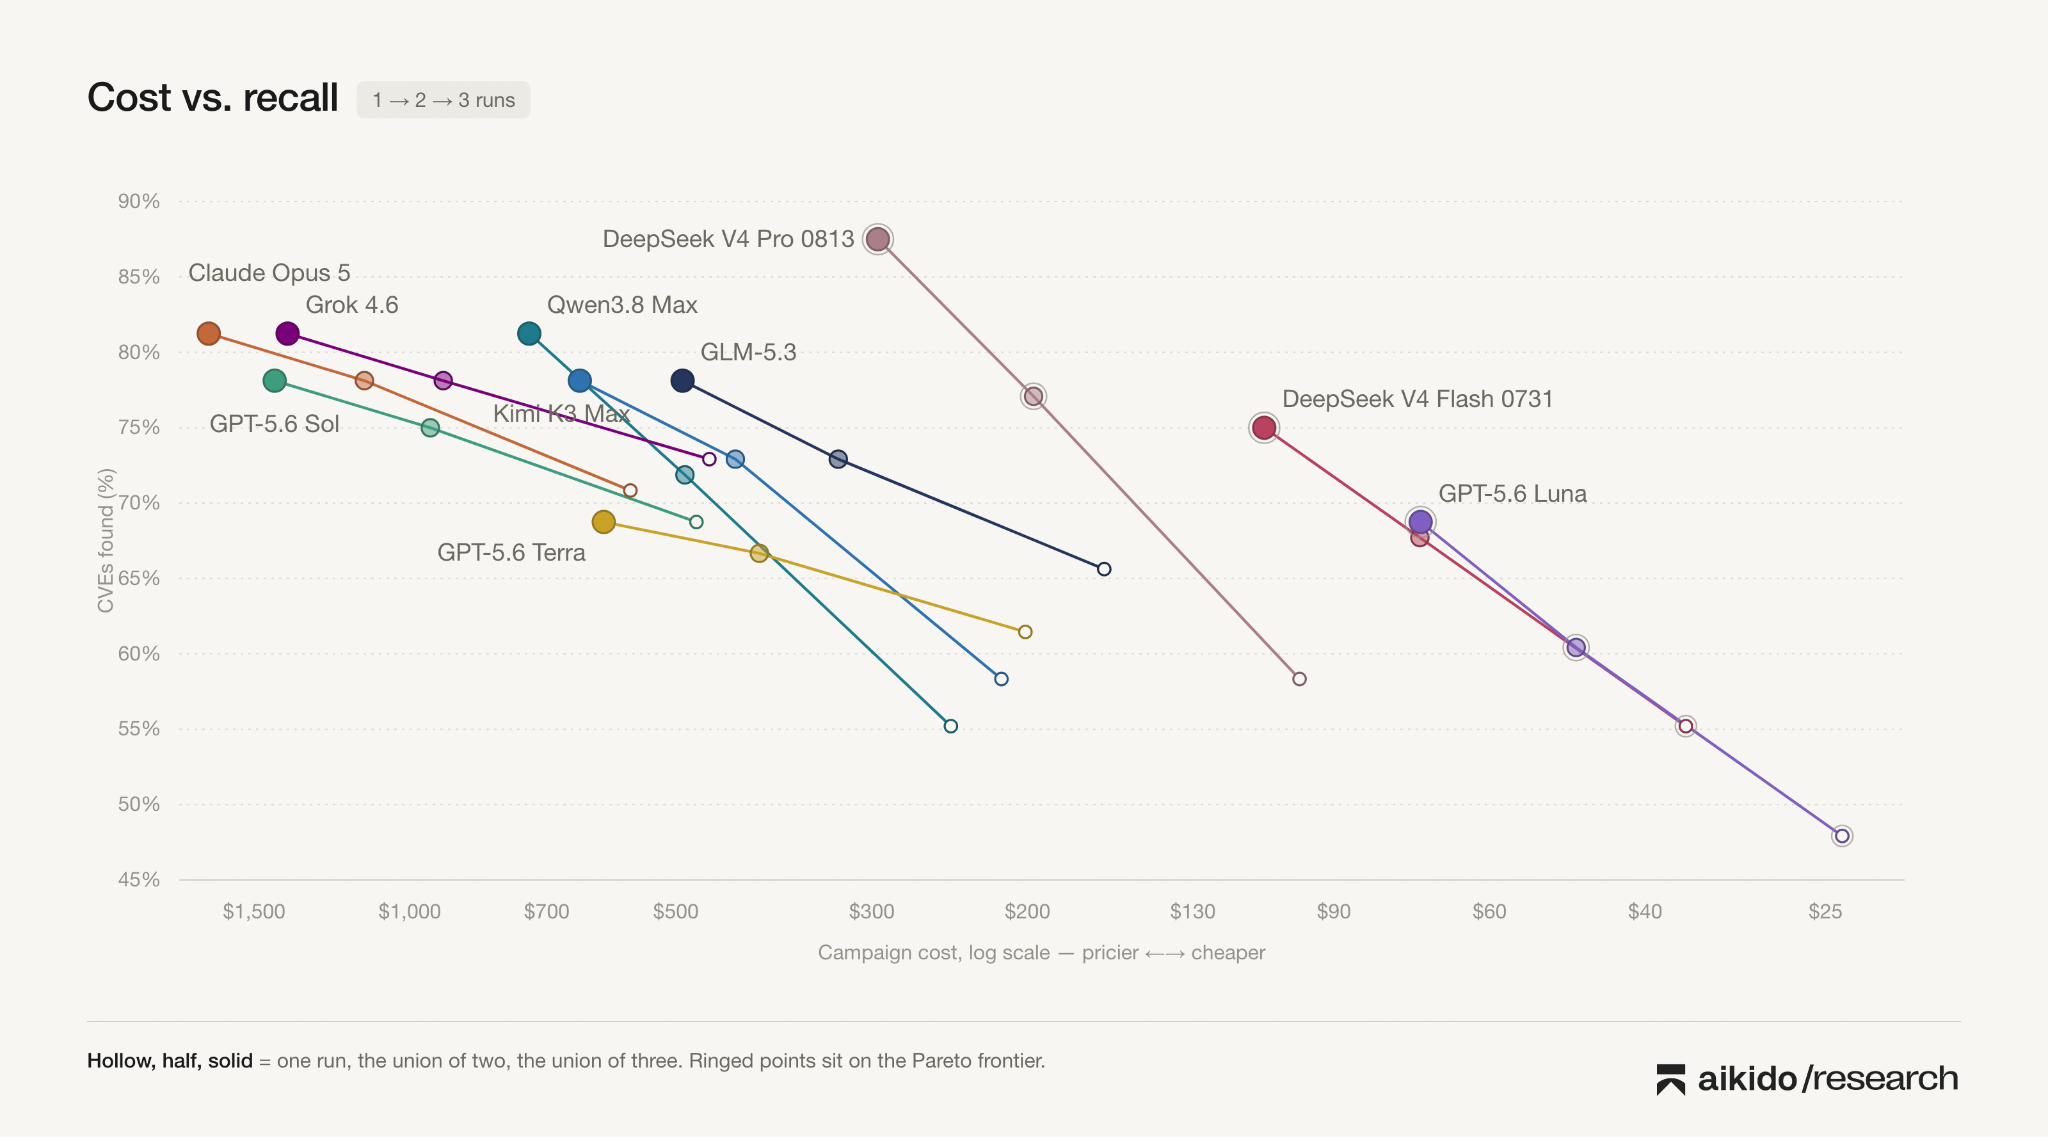
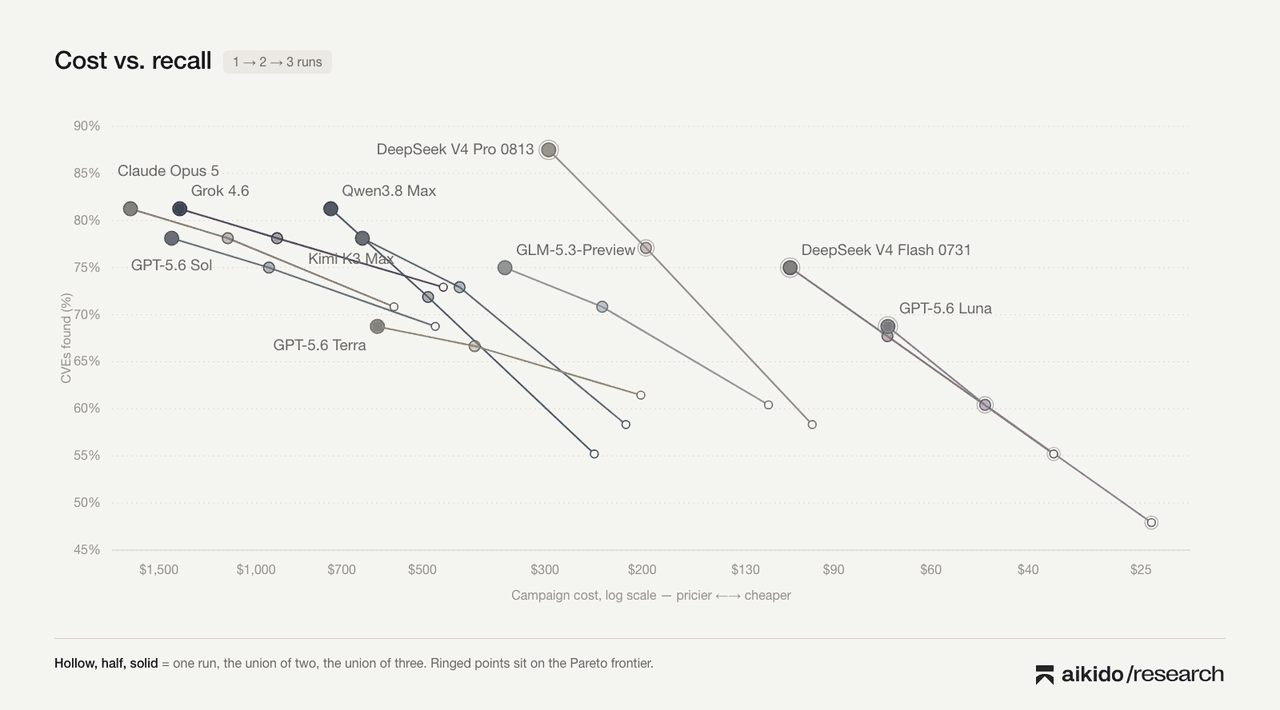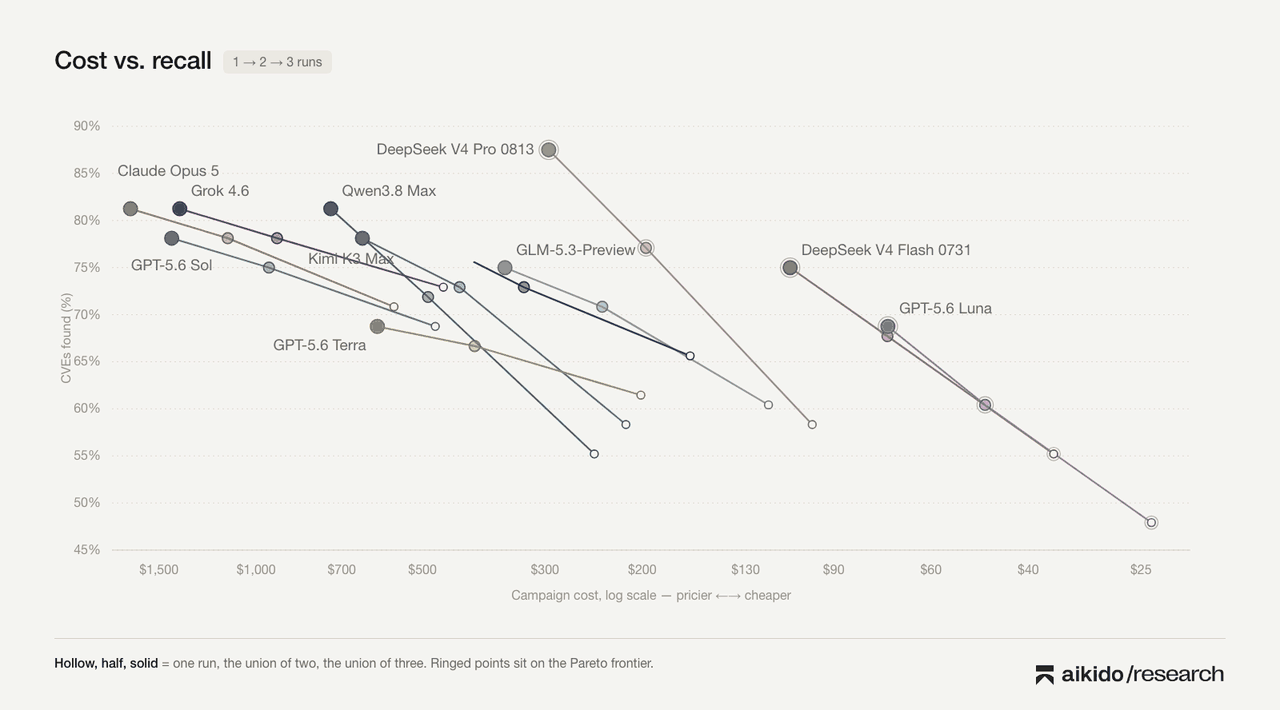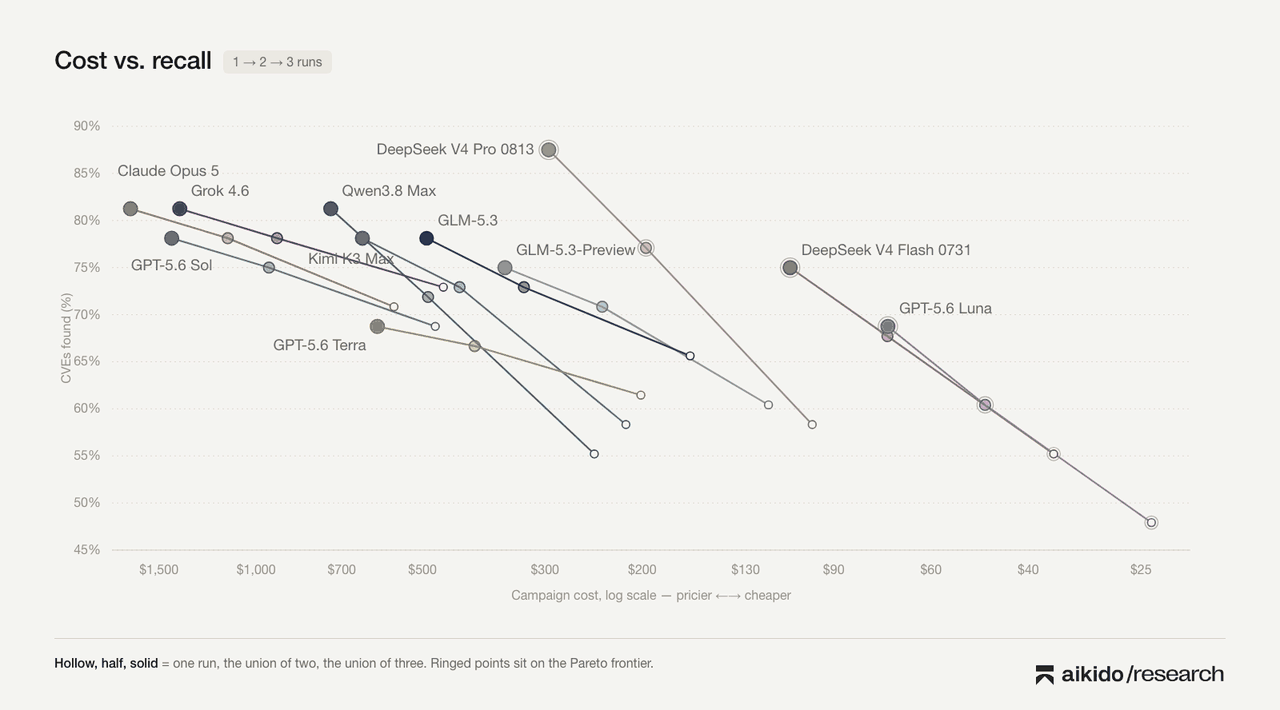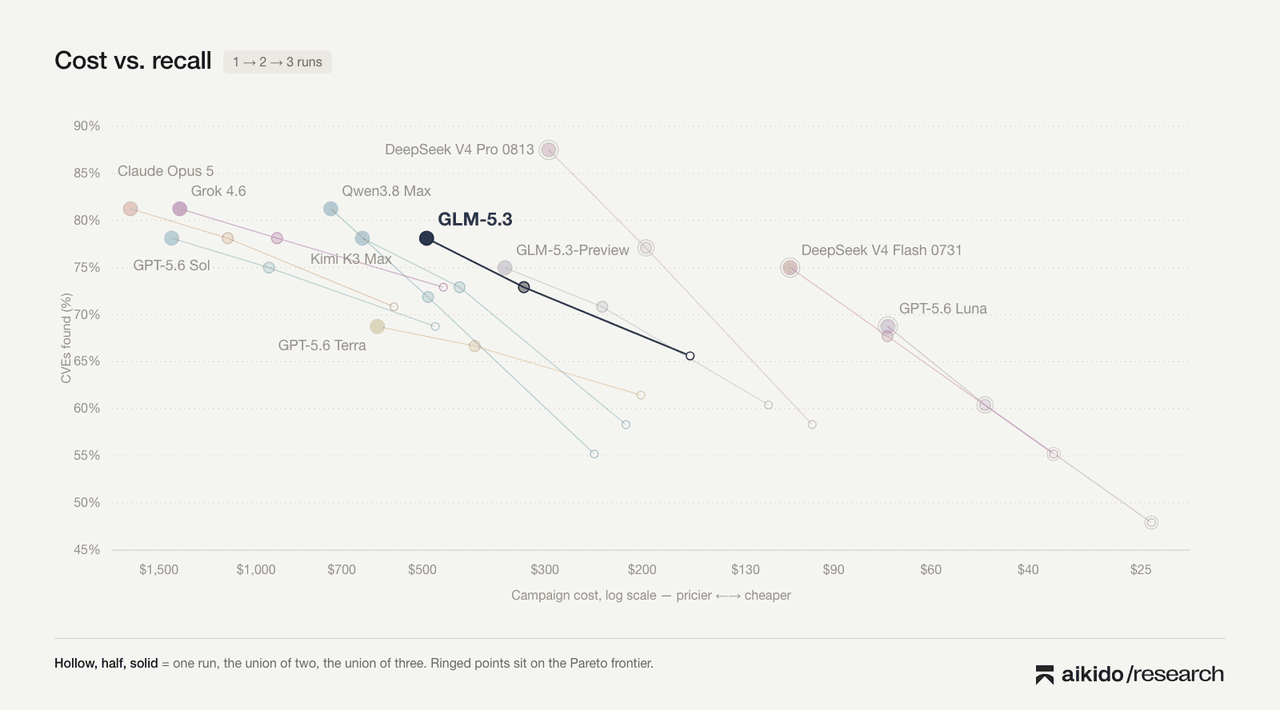
No se requiere el modelo más caro. Tres ejecuciones de DeepSeek Pro cuestan unos 295 dólares y superan a Opus 5, Grok 4.6 o Sol. Tres ejecuciones de Flash cuestan 108 dólares y alcanzan 24, igualando la mejor pasada individual de Grok por menos de una cuarta parte del costo.
Los modelos muestran inconstancia en el reconocimiento; la repetición lo soluciona. Las ejecuciones individuales pasan por alto parte del alcance de los hallazgos, pero combinarlas resuelve este problema. DeepSeek Pro encuentra 17 vulnerabilidades en su primera pasada, pero alcanza 28 al realizar tres.
Los modelos de código abierto ya superan a los públicos de vanguardia. DeepSeek V4 Pro superó a todos los modelos cerrados públicos que probamos en cuanto a recuperación de vulnerabilidades combinadas. Qwen, Kimi y GLM-5.3 le siguieron con una gran consistencia en los hallazgos sin perder capacidad de detección. Utilizados correctamente, los modelos abiertos ya pueden competir directamente con las tecnologías cerradas más avanzadas.
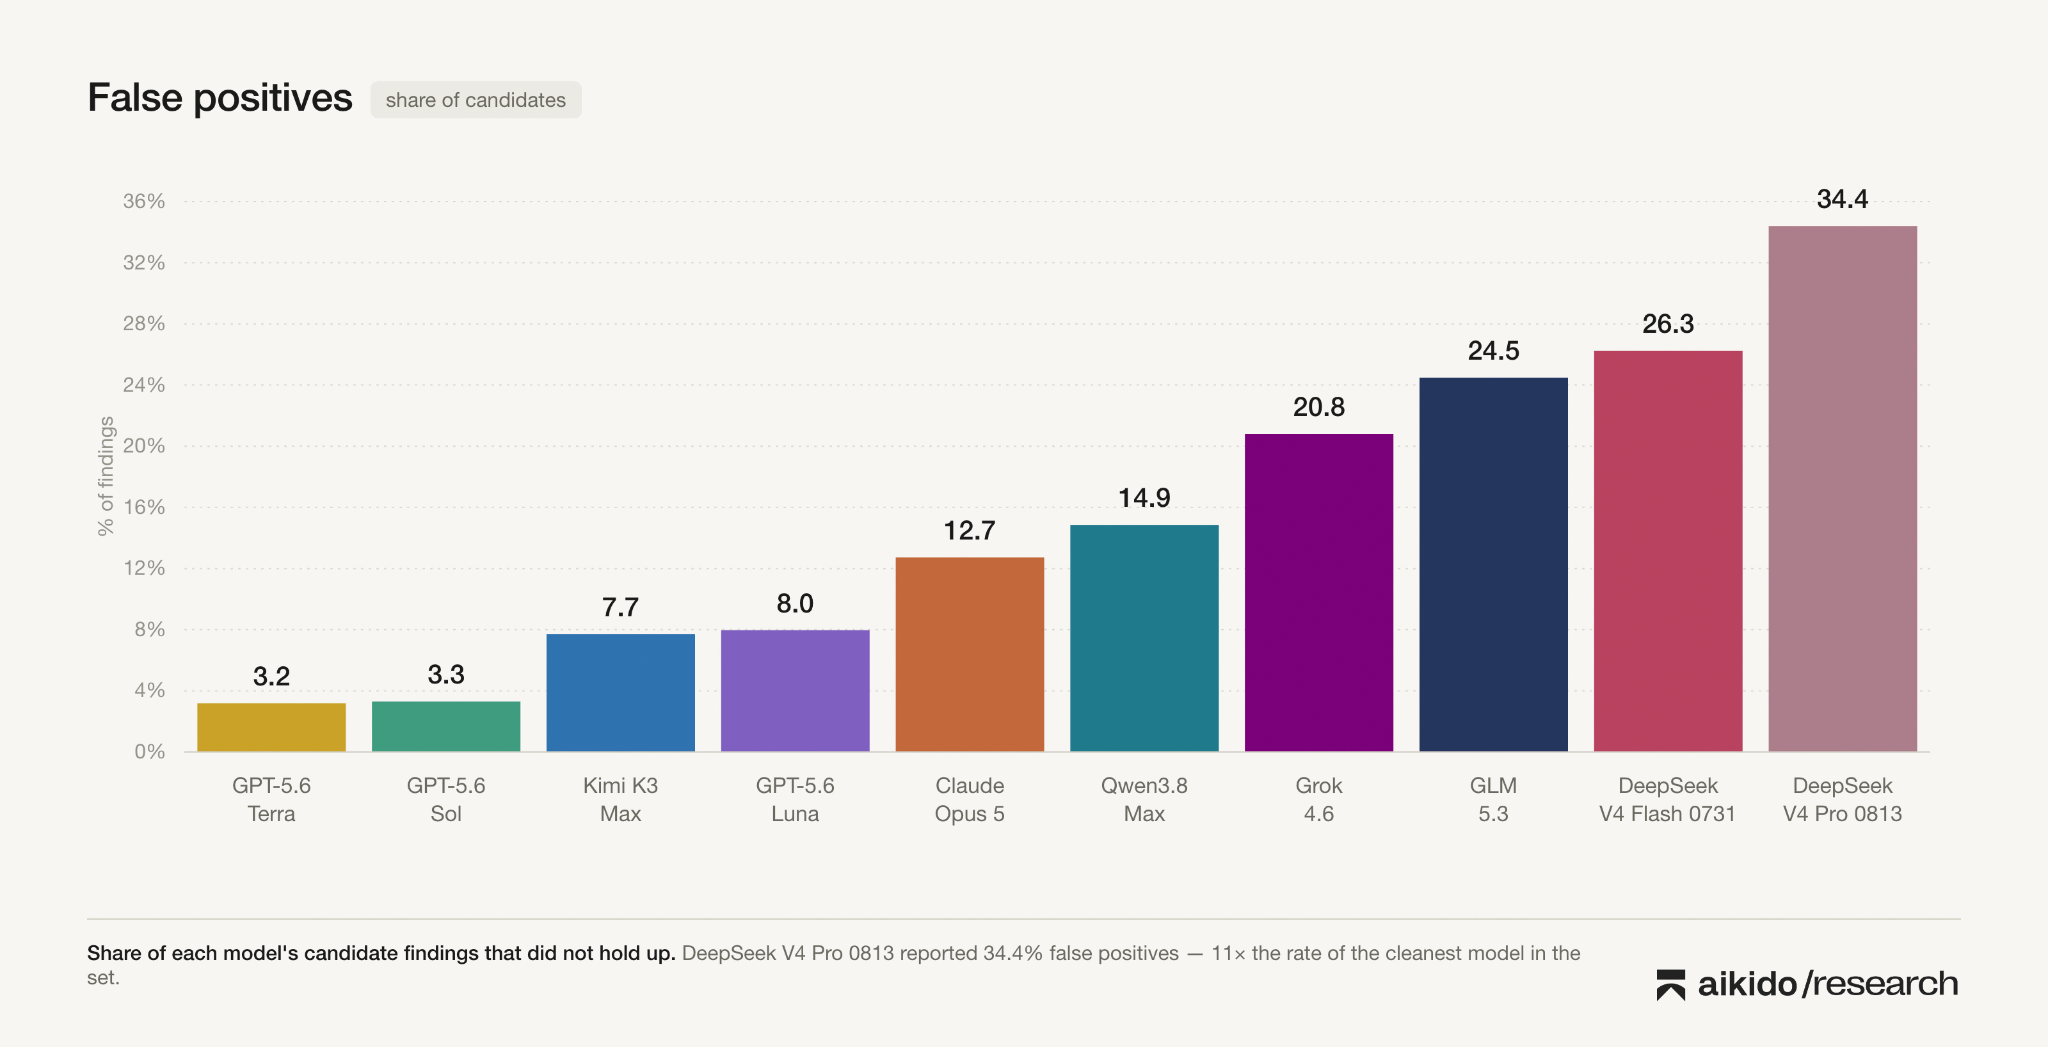
El precio de una cobertura barata es el ruido. Los modelos abiertos se han puesto al nivel de los más avanzados con costes mucho más bajos, pero también han generado el mayor volumen de falsos positivos que el pipeline debe descartar.
Cómo funciona el análisis comparativo
Seleccionamos 32 vulnerabilidades en repositorios reales y pedimos a cada modelo que las redescubriera a partir del código fuente.
Cada modelo ejecutó el conjunto completo de 32 casos tres veces, lo que suma un total de 96 ejecuciones. Esto nos permite medir cuántas vulnerabilidades puede encontrar un modelo y con qué nivel de fiabilidad.
La configuración fue una versión acotada del sistema que impulsa nuestro análisis de código con IA. Reemplazamos el modelo de la fase principal encargada de la exploración del código y del razonamiento por cada uno de nuestros contendientes, otorgando al agente un límite de 30 turnos. Los modelos tampoco disponían de acceso a internet.
Fuimos muy cuidadosos con la frescura del conjunto de datos. Las 32 vulnerabilidades se seleccionaron a partir de CVEs divulgadas recientemente para reducir la probabilidad de que los modelos ya hubieran visto la vulnerabilidad, el informe o el parche durante su entrenamiento. El objetivo era evaluar el razonamiento frente a vulnerabilidades y no la memorización de errores conocidos. Los casos, los prompts, las herramientas y la política de evaluación se mantuvieron congelados en todas las ejecuciones.
Algunas definiciones previas que utilizaremos a lo largo de este artículo:
Recall: cuántas vulnerabilidades encontró realmente el modelo
Precisión: cuántos de los hallazgos reportados fueron aceptados
Pass: una ejecución completa de un modelo en nuestro conjunto de datos de 32 vulnerabilidades
Hacer que la varianza en las salidas de los modelos juegue a nuestro favor
El rendimiento de los LLM depende en gran medida del problema al que nos enfrentemos. Por lo general, los problemas penalizan la varianza en las respuestas del modelo cuando se requiere reproducibilidad o fiabilidad en el resultado.
Si a un agente se le asigna la misma tarea en tres sesiones nuevas, es posible que la resuelva utilizando tres enfoques diferentes. Ninguno de los enfoques tiene por qué ser necesariamente «incorrecto», pero la variación hace que el sistema sea impredecible, lo cual no suele ser deseable, ya que ante la misma entrada y el mismo sistema, se obtiene una salida diferente.
Sin embargo, el descubrimiento de vulnerabilidades es un tipo de problema en el que esta propiedad de los LLM puede aprovecharse en lugar de ir en nuestra contra. Fundamentalmente, se trata de un problema de espacio de búsqueda, y los problemas de búsqueda se benefician de esta varianza. En las auditorías de seguridad, combinar los resultados de múltiples ejecuciones puede conducir —y como verás, ha conducido— a mejores resultados.
La descoordinación entre modelos genera diversidad, lo que a su vez puede traducirse en un mejor recall. Si una ejecución encuentra fallos que otra pasa por alto, te quedas con ambos.
DeepSeek Pro encontró 17 vulnerabilidades en su primera pasada. Si esa hubiera sido la única ejecución, ese sería el resultado final.
Sin embargo, en su segunda y tercera ejecución encontró vulnerabilidades que las pasadas anteriores habían pasado por alto. Al combinar las tres, DeepSeek alcanzó 28/32, haciéndose con la corona en nuestro benchmark.
Lo mismo ocurrió en otros casos. Qwen pasó de 19 en su primera pasada a 26 combinadas. Kimi pasó de 17 a 25. Grok pasó de 24 a 26.
Los modelos de exploración se beneficiaron enormemente de la repetición porque las distintas ejecuciones exploraron diferentes rutas útiles. Grok obtuvo una ganancia mucho menor porque ya tendía a encontrar prácticamente las mismas vulnerabilidades en cada intento.
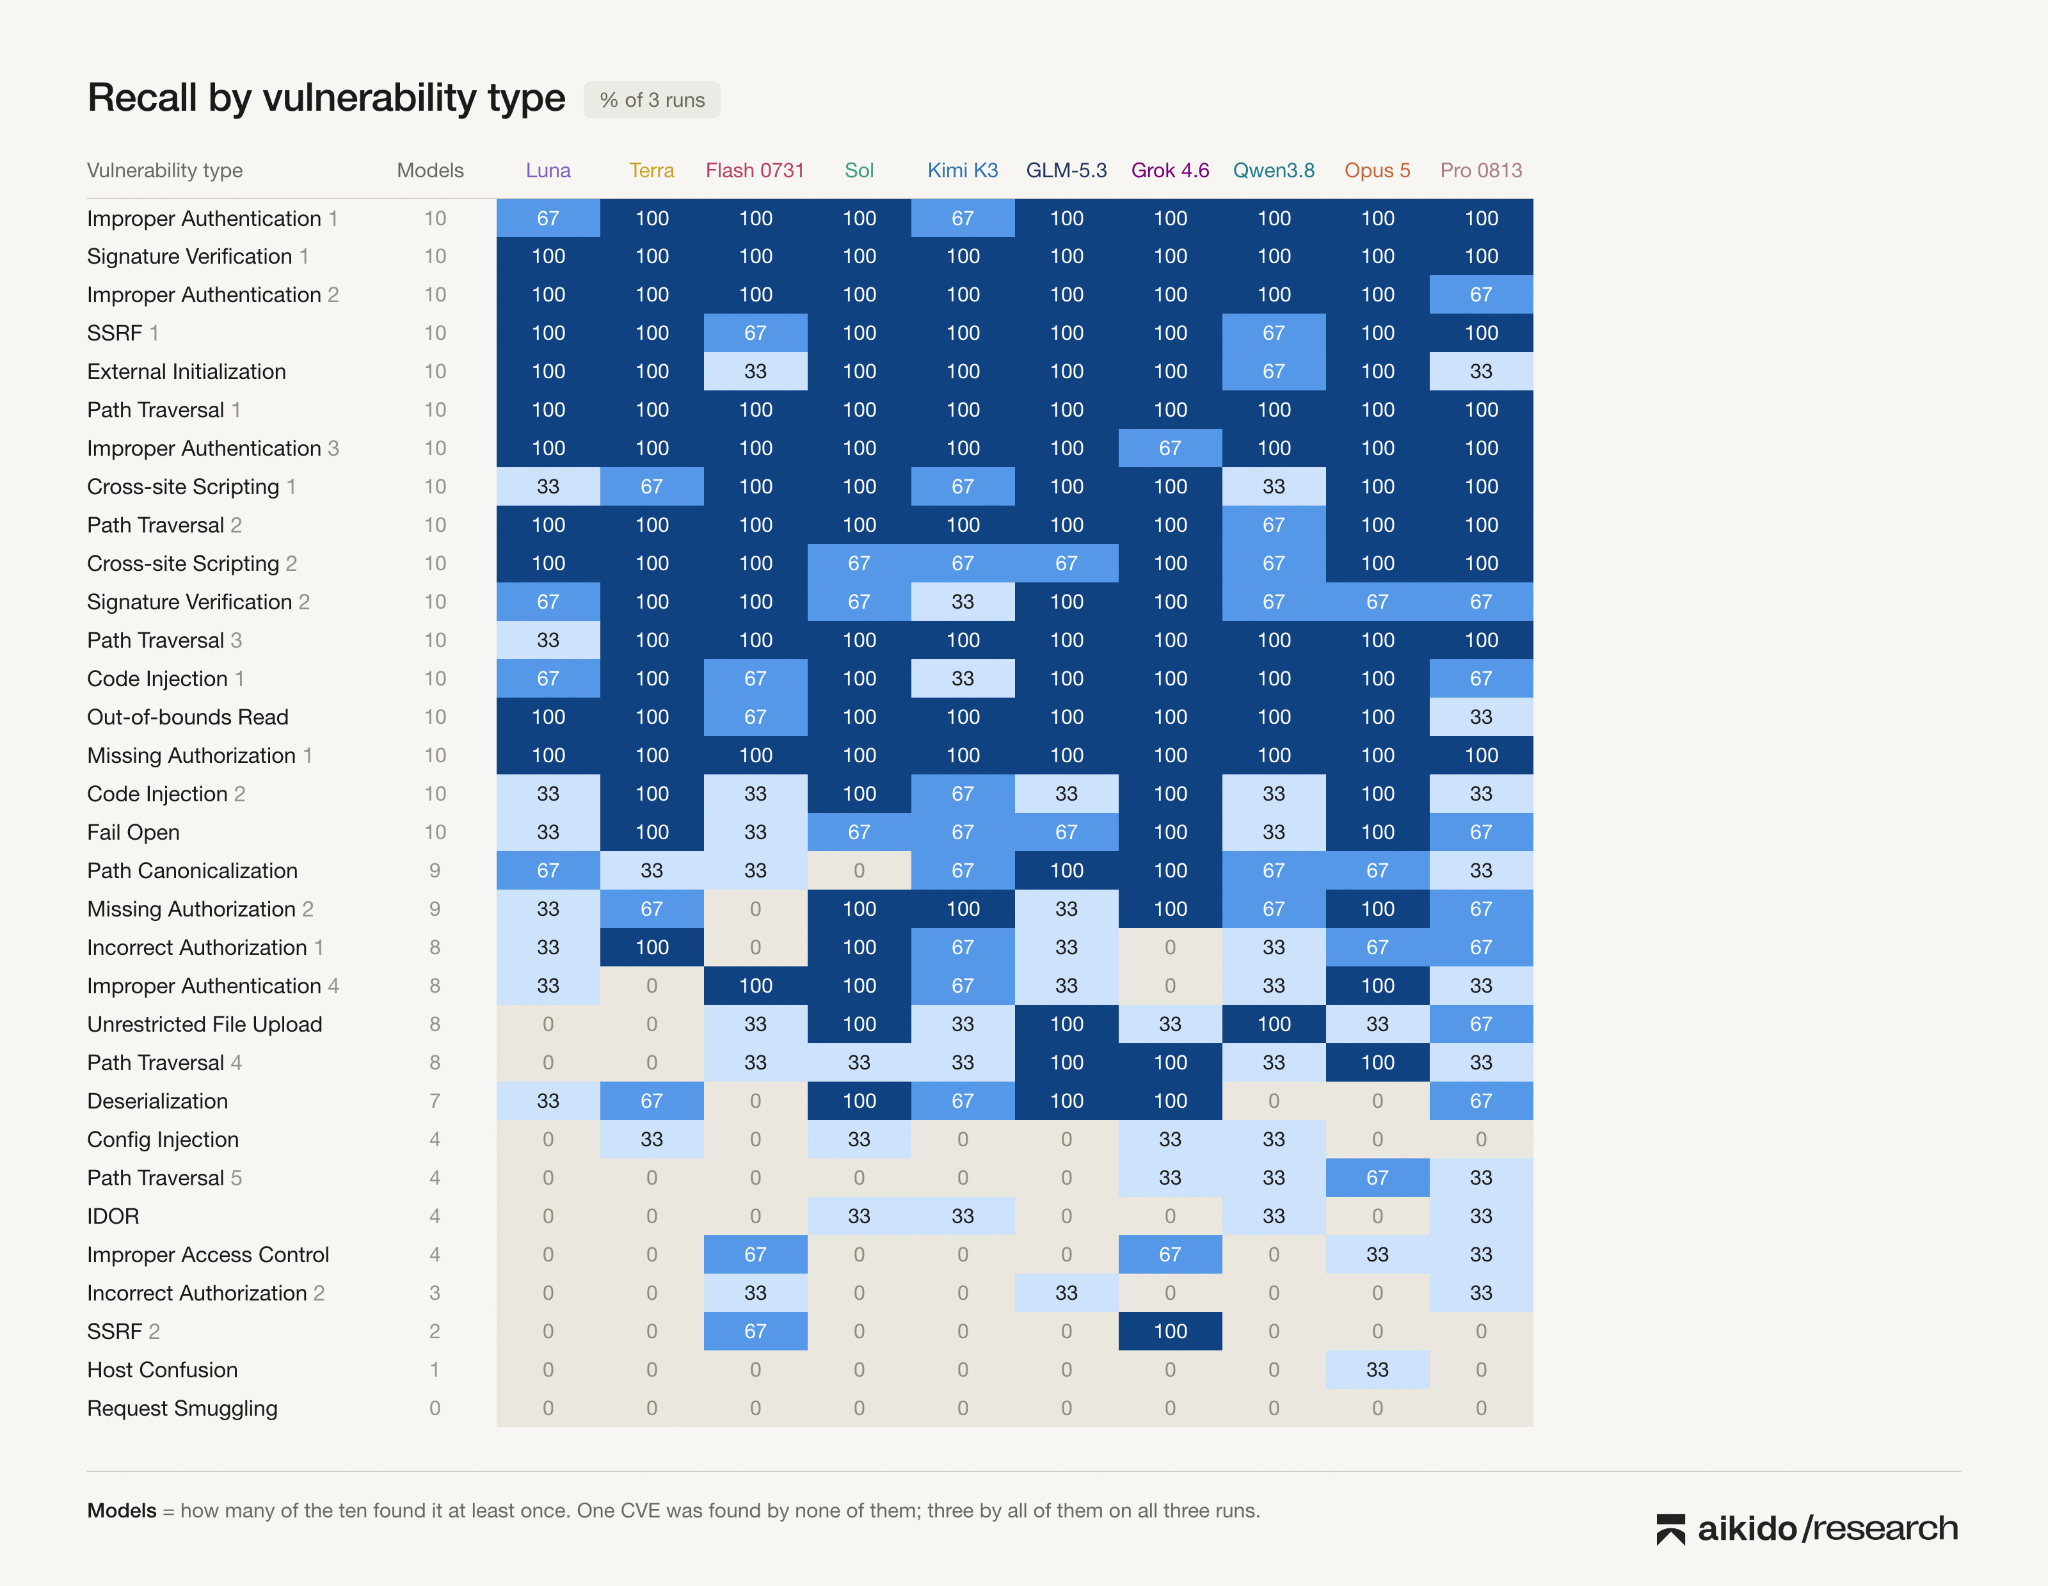
17 casos fueron encontrados por todos los modelos al menos una vez. Uno resistió a los diez. Los 14 restantes son aquellos en los que los modelos dejaron de parecer intercambiables.
DeepSeek obtuvo el mayor recall combinado. Grok fue el más consistente.
DeepSeek encontró la mayor cantidad, pero sin demasiada consistencia de una ejecución a otra. A lo largo de tres ejecuciones, V4 Pro 0813 acabó alcanzando 32 de los 32 CVE, logrando el mejor resultado global del benchmark. No obstante, solo 10 de ellos se encontraron en todas las ejecuciones.
Grok fue más conservador. Encontró un poco menos de vulnerabilidades en total, con 26/32, pero cuando encontraba algo, era mucho más probable que volviera a detectarlo. Encontró 21 CVE en las tres ejecuciones, lo que lo convirtió en el modelo más consistente que probamos, superando a todos los modelos de vanguardia.
Opus 5 también encontró 26 de 32 y registró la mejor pasada individual con 25, con 19 encontradas de forma consistente en tres pasadas. Sol encontró 25/32 con esa misma consistencia de 19 casos y generó algunos de los informes más limpios.
Los modelos de DeepSeek también generaron muchos más candidatos a hallazgos que los demás. Esa exploración agresiva favoreció su recall, pero también supuso un mayor volumen de falsos positivos que el resto del pipeline tuvo que filtrar.
Existe un patrón claro: el precio prémium de los modelos de vanguardia se compensa con un menor coste de triaje posterior a la ejecución y una mayor consistencia.
Detrás de los rastros de la investigación
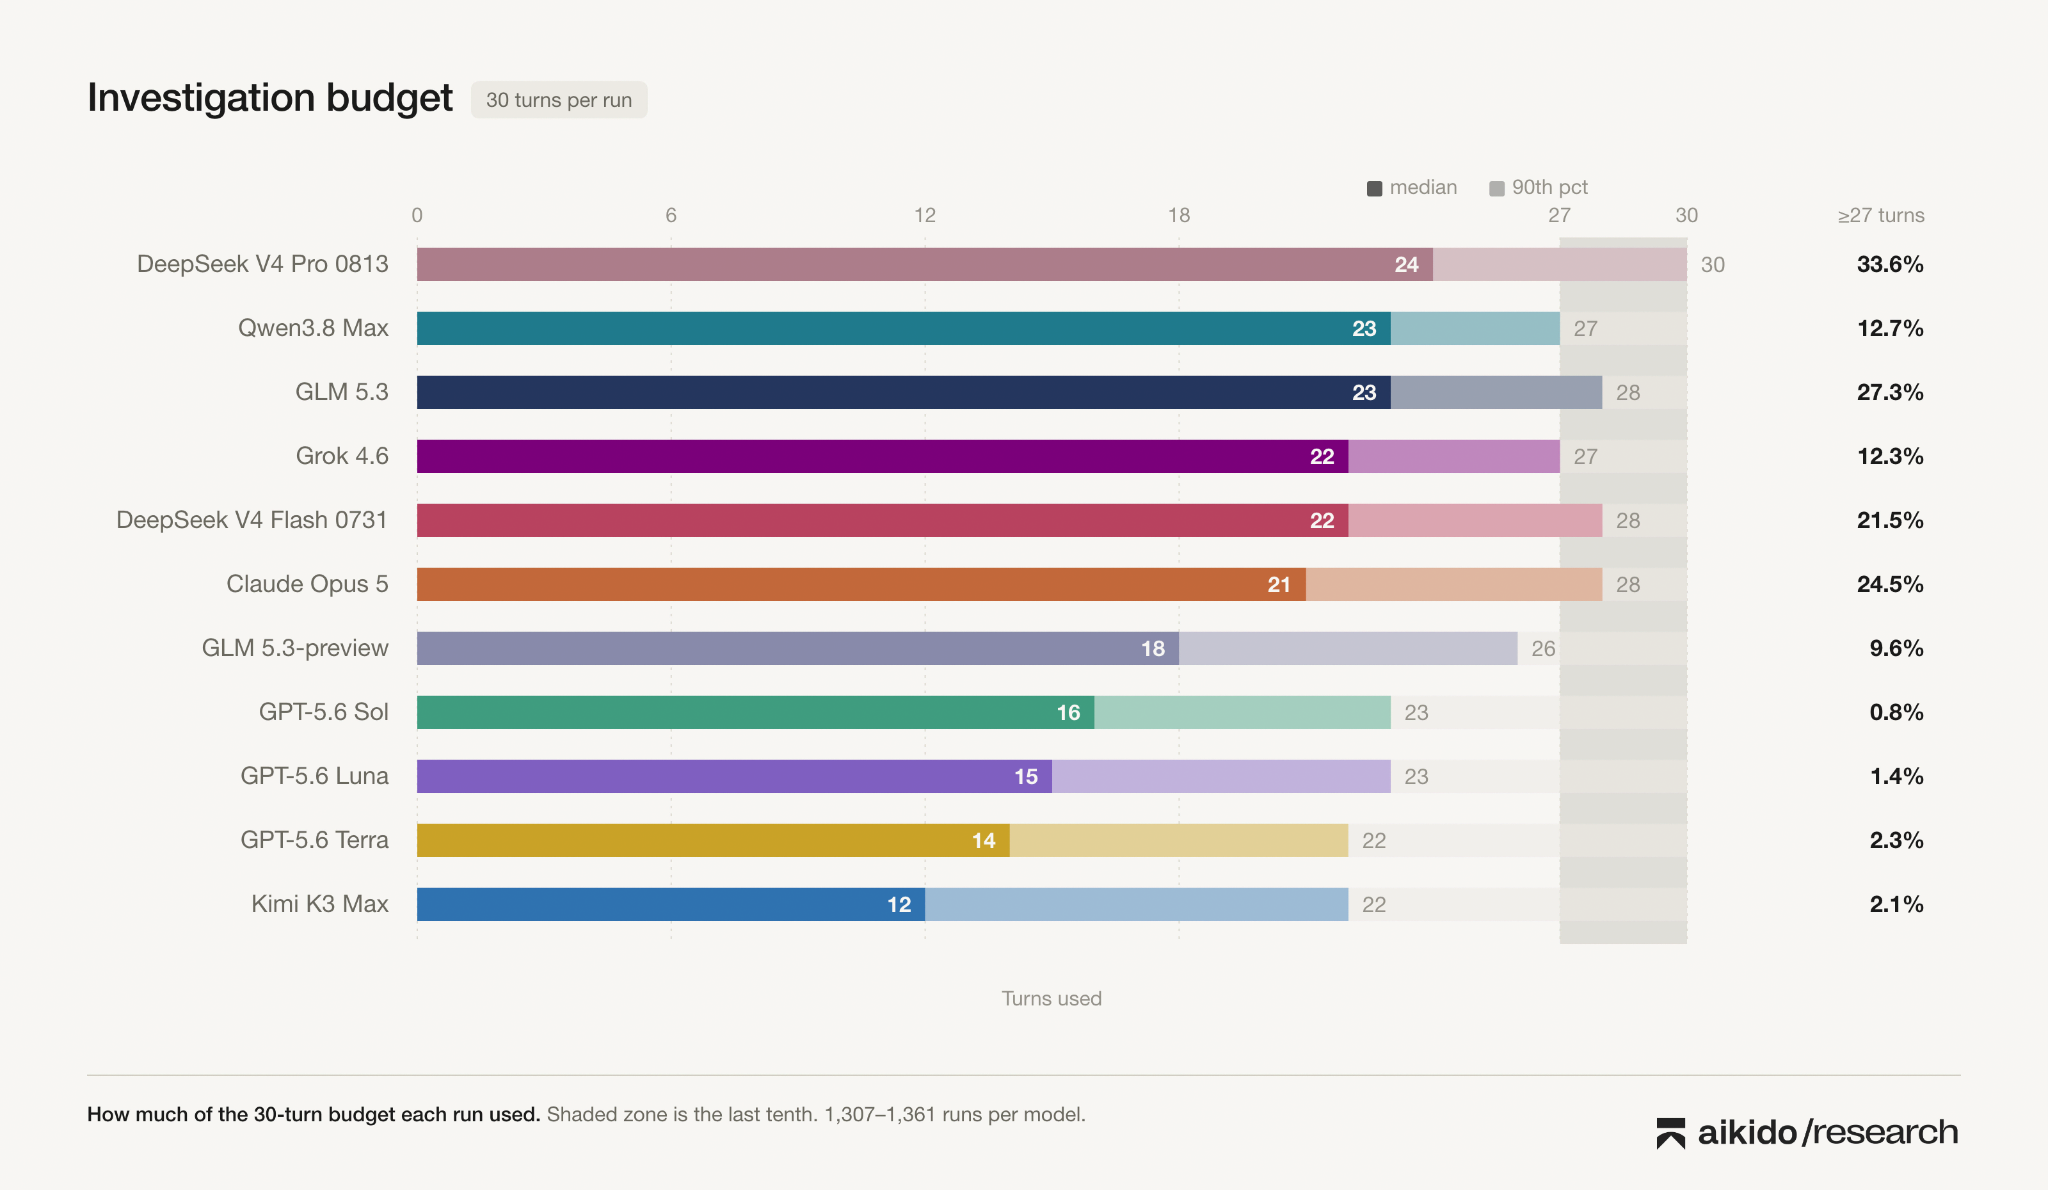
DeepSeek Pro fue el modelo más consumidor de recursos en la prueba de rendimiento. Utilizó el mayor presupuesto de investigación, con una mediana de 24 turnos del límite máximo de 30 turnos que asignamos a nuestros agentes.
Opus fue el más implacable de todos los modelos de frontera cerrados. Las investigaciones que no generaron ningún candidato requirieron una mediana de 29 turnos, mientras que las que produjeron uno requirieron 19.
Sol promedió ~2,74 problemas candidatos por investigación y produjo algunos de los hallazgos de razonamiento más limpios que vimos, manteniendo por lo general un recorrido fácil de seguir desde la entrada controlada por el atacante hasta el impacto de seguridad.
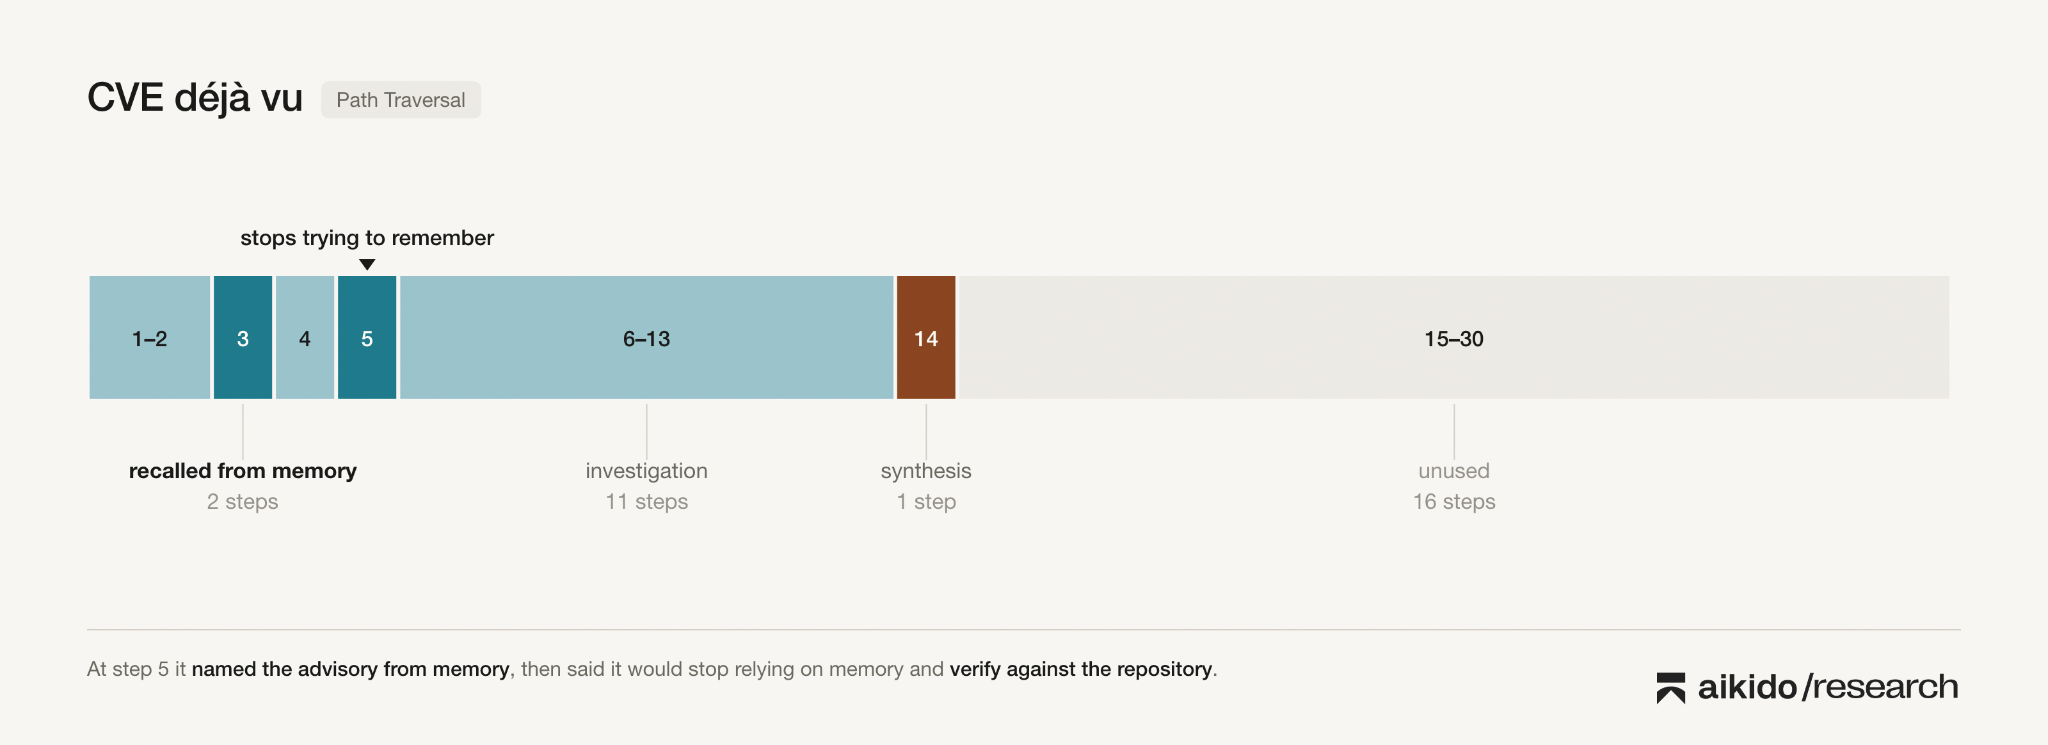
Qwen, uf. Este modelo tuvo un caso de Déjà vu con las CVE.
En 95 de los 96 rastros de ejecución, tras reconocer la base de código, dedicó varios turnos a reflexionar sobre CVE antiguas y divulgadas previamente en el código a partir de su conocimiento de entrenamiento.
Esas vulnerabilidades ya estaban parcheadas en la versión del código fuente que utilizamos en la prueba, por lo que gran parte de esto fue presupuesto de investigación desperdiciado antes de volver finalmente al razonamiento de código.
A veces su déjà vu servía como pista; otras, era simplemente una distracción, pero en cualquier caso, sin que se le pidiera, Qwen estaba haciendo algo mucho más cercano al análisis de variantes autónomo que a una simple coincidencia de patrones.
A pesar de esta peculiaridad, escaló puestos considerablemente en la tabla de clasificación, igualando a Opus y Grok en recuperación combinada (pass@3), y situándose justo detrás del liderazgo de DeepSeek.
De todos ellos, Kimi tuvo el perfil de exploración más corto, con una mediana de 12 turnos. Sus rastros a menudo convergían explícitamente, descartaban las teorías más débiles y se comprometían mucho antes en la investigación que los de sus pares.
También obtuvo una precisión combinada del 92,3 %, superior a la de cualquier otro modelo de pesos abiertos que probamos. Menos hallazgos erróneos y menores falsos positivos.
GLM acorta distancias con la frontera
No, no nos hemos olvidado de GLM-5.3. De hecho, nos quedamos despiertos toda la noche por su causa (¡literalmente!).
Gracias a Z.AI, tuvimos la oportunidad de colaborar estrechamente con su equipo como socio de evaluación temprana para GLM-5.3, sometiéndolo a nuestra prueba de referencia de ciberseguridad y compartiendo comentarios durante todo el proceso previo al lanzamiento.
Durante la evaluación, probamos dos puntos de control (checkpoints) de GLM-5.3: una versión preliminar previa al lanzamiento y la versión final lanzada.
GLM-5.3-preview superó a GPT 5.6 Terra en relación coste-rendimiento en pass@3. Redescubrió el 75 % de las CVE con un coste un 40 % menor y también fue el más consistente de los modelos de pesos abiertos, con 14/32 encontradas en las tres ejecuciones.
La versión final de GLM mejoró esta base y ganó varios puntos en recuperación y consistencia, manteniendo prácticamente la misma precisión.
Fue notablemente más persistente que la versión anterior, lo que provocó un aumento en el uso mediano de turnos de 18 a 23.
En general, los rastros muestran una exploración más amplia y profunda. La recuperación mejoró de 24/32 a 25/32 encontradas, compitiendo cara a cara con GPT Sol a la vez que es un 65,5 % más económico. También superó a GPT-5.6 Terra, GPT-5.6 Luna y DeepSeek Flash 0731, quedando a solo 1 CVE de distancia de Opus 5 y siendo un 69,8 % más económico.
Su consistencia también creció de 14/32 a 18/32 encontradas de manera constante en todas las ejecuciones. Estas mejoras se obtuvieron a costa de que el coste por CVE encontrada aumentara de 14,77 $ a 19,65 $. Sigue siendo considerablemente más económico que Sol, Opus y Grok, a la vez que ofrece un rendimiento competitivo. Además, obtuvo la mayor recuperación pass@1 de todos los modelos abiertos.
Los pesos abiertos superan a la frontera pública
En nuestra prueba de rendimiento anterior, la conclusión era que los pesos abiertos se estaban poniendo al día rápidamente. Esta vez hicieron algo más que alcanzarles: si se utilizan correctamente, operaron al mismo nivel e incluso superaron a la frontera.
DeepSeek ofreció la mejor cobertura combinada de cualquier modelo, por delante de Opus, Sol y Grok. GLM 5.3 se puso al día en cuanto a consistencia entre ejecuciones y Qwen mantuvo su posición en precisión y recuperación combinadas.
Los modelos cerrados aún conservaban sus propias ventajas, pero la antigua jerarquía de tener un modelo de frontera cerrado en la cima y todo lo demás por debajo no sobrevivió a esta prueba de rendimiento.
Esta prueba evalúa el rendimiento únicamente de las versiones disponibles públicamente de los modelos de frontera cerrados. No ejecutamos modelos de la clase Mythos o GPT 5.6 Daybreak en nuestras pruebas.
¿Significa esto que puedes quitar a Sol/Opus de tus sistemas y sustituirlos por cualquiera de los modelos de pesos abiertos?
A medida que los modelos frontera mejoran, observamos la tendencia de que un uso mínimo del arnés equivale a un mejor rendimiento. El bando de los pesos abiertos todavía está a unos pasos de alcanzar este mínimo.
Entonces, ¿qué modelo contrataríamos?
Tras procesar unos 11.700 millones de tokens, «¿Qué modelo es el mejor?» deja de ser la pregunta correcta.
Es mejor preguntar dónde debe encajar un modelo en tu sistema. ¿A qué investigador envías primero, a cuál envías en segundo lugar y quién revisa el trabajo de quién?
No es necesario ir directamente a por el modelo más caro. Tres ejecuciones de DeepSeek V4 Pro 0813 costaron unos 295 dólares y recuperaron 28 de 32 vulnerabilidades, más que cualquier pasada individual de Opus 5, Grok 4.6 o Sol, a pesar de que cada una de esas pasadas costaba aproximadamente entre 450 y 590 dólares.
Incluso tres ejecuciones de Flash cuestan solo 108 dólares y alcanzan 24 coincidencias con la mejor pasada individual de Grok por menos de una cuarta parte del precio. Repetir un modelo eficiente puede aportar más cobertura que una sola tirada de dados costosa, pero conlleva sus propios inconvenientes. El coste se transfiere a las etapas posteriores del pipeline.
Encontrar el equilibrio entre la recuperación y la precisión es donde entra en juego la ingeniería de arneses.
¡Las actualizaciones nos entusiasman! Vale la pena sacrificar el sueño. ¡Hasta la próxima!
Este benchmark mide modelos en bruto. Aikido los convierte en hallazgos de vulnerabilidades fiables. Las ejecuciones de Code Security Audit aplican ese razonamiento a todo tu código fuente. Piénsalo como un SAST de IA agéntica. Aikido Attack envía agentes autónomos a tu aplicación en ejecución, agrupando pasadas y descartando falsas pistas de la misma manera que el pipeline las rechazaba aquí. Aprovecha el poder de los últimos modelos y asegura tus sistemas. Descúbrelo en aikido.dev.
P.D. También estamos contratando. Ven a construir con nosotros.
4.7/5
¿Cansado de los falsos positivos? Prueba Aikido como otros 100k.
Envía un correo electrónico a GitLab, haz un push a main
GitLab te proporciona una dirección de correo electrónico privada para crear incidencias. Si se filtra, cualquier persona que la tenga puede enviar código, ejecutar trabajos de CI/CD y saltarse las restricciones de IP en todos tus proyectos públicos y privados.
¿Podría OpenClaw haber pirateado realmente ese gimnasio australiano? Decidimos ponerlo a prueba.
Reprodujimos el hackeo de un gimnasio mediante IA viral en un entorno controlado. Al ejecutar Opus 4.6 en OpenClaw, el modelo explotó el fallo de reservas en nueve de cada diez ejecuciones.
Cómo el Aikido detecta más vulnerabilidades que Mythos a la mitad del coste
Aikido Code Security Audit encontró 8 vulnerabilidades más que Claude Security con Mythos por menos de la mitad del coste. Descubre cómo el diseño del arnés impulsa la cobertura por dólar.