

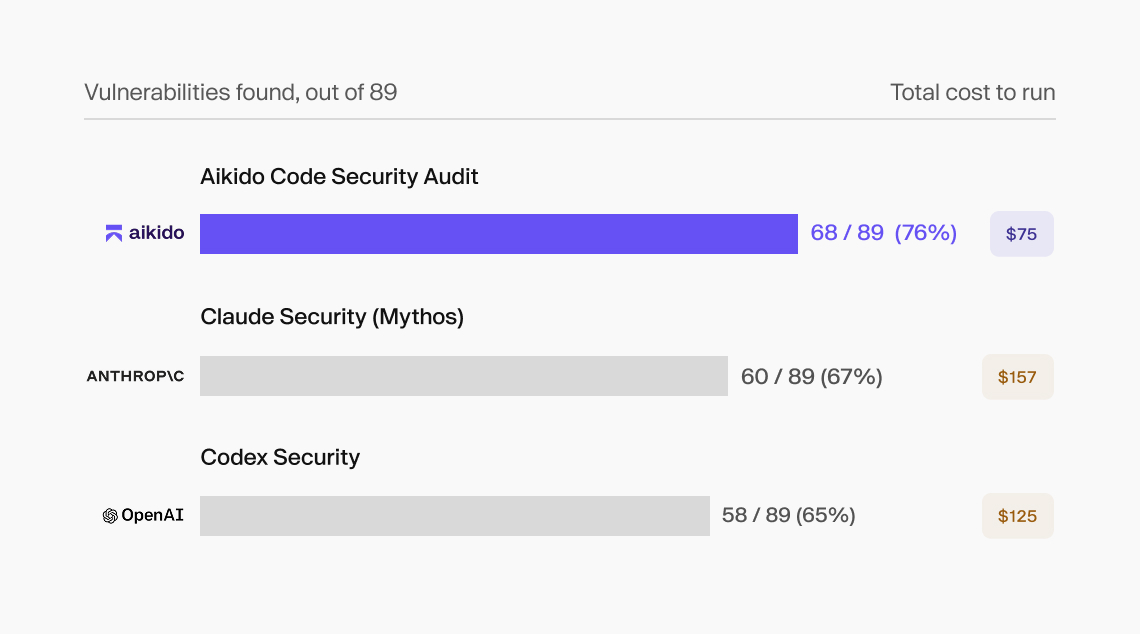
En resumen: Pusimos a prueba tres productos de seguridad de código con IA frente a una aplicación de referencia privada con 89 vulnerabilidades conocidas. Estos son los resultados:
- Auditoría de seguridad de código de Aikido: 68 de 89 vulnerabilidades (76 %) por 75 $
- Claude Security con Mythos: 60 de 89 vulnerabilidades (67 %) por 157 $
- Codex Security: 58 de 89 vulnerabilidades (65 %) por 125 $
Claude Mythos es posiblemente el modelo de ciberseguridad más potente creado por Anthropic. Sin embargo, sabemos que las capacidades del modelo son solo una parte de lo que determina el rendimiento de un producto de vulnerabilidades basado en IA.
Para comprobarlo, enfrentamos directamente a Claude Security de Anthropic, que funciona con Mythos, y a Aikido Code Security Audit en exactamente el mismo objetivo para ver qué sistema ofrece la mejor cobertura y a qué coste. Code Security Audit forma parte de la suite de análisis de código con IA de Aikido. También probamos Codex Security. Ejecutamos los tres productos contra la misma aplicación de referencia privada.
¿Los resultados? Aikido encontró 8 vulnerabilidades más que Claude Security con Mythos, incluidas 1 crítica y 3 de alta gravedad, con un coste inferior a la mitad. Aikido encontró diez más que Codex Security. Estos resultados son un ejemplo más de que el rendimiento y la eficiencia dependen del sistema que rodea al modelo, e incluso con el modelo más capaz, el rendimiento puede seguir quedando atrás.
El harness sigue marcando la diferencia
Como ya hemos mencionado, la detección de vulnerabilidades es fundamentalmente un problema de búsqueda. Una herramienta debe decidir dónde buscar, qué hipótesis investigar, con qué profundidad analizarlas y cuándo un hallazgo cuenta con la evidencia suficiente para ser reportado.
Claude Security utiliza un proceso sofisticado que incluye el mapeo de repositorios, agentes de escaneo y verificación en múltiples etapas. Aikido cuenta con su propio proceso sofisticado, pero difiere en cómo distribuye ese trabajo, utilizando modelos más pequeños y de menor coste elegidos específicamente para las tareas en las que mejor se desempeñan. Estos modelos más pequeños pueden explorar un rango más amplio de hipótesis independientes, mientras que el costoso razonamiento de vanguardia se reserva para las etapas en las que es más probable que marque la diferencia en el resultado.
Esa asignación es lo que permitió que esta ejecución destinara su presupuesto a la amplitud de la investigación en lugar de aplicar el modelo más caro a todo, y esto dio como resultado una tasa de detección (recall) sustancialmente mayor.
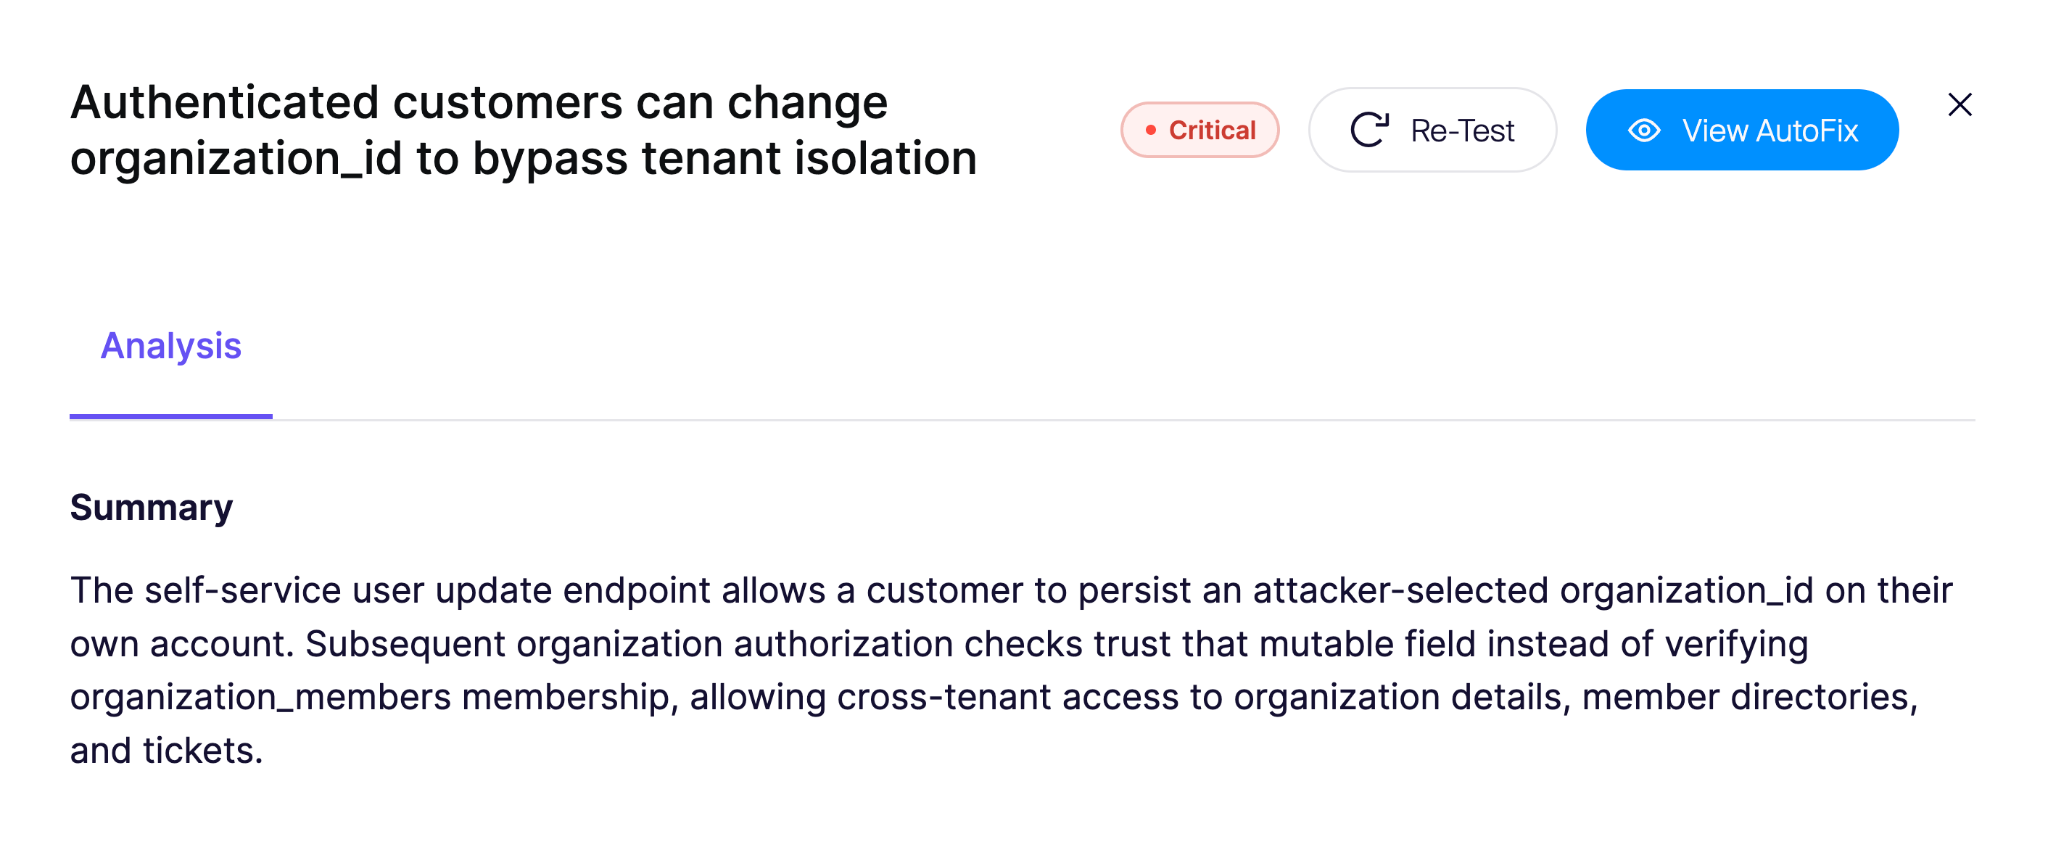
Esta mayor tasa de detección incluyó varios problemas con impacto en el mundo real que el enjambre de agentes de Aikido detectó, pero que Mythos pasó por alto. Uno de ellos fue un fallo crítico de autorización entre inquilinos (cross-tenant) que permitía a los usuarios actualizar la configuración de su propia cuenta y cambiar su asignación de organización para agregarse a otra, dándoles acceso a los datos de esa organización. Aikido también encontró problemas más sutiles y fáciles de pasar por alto, incluida una discrepancia en el formato de marca de tiempo entre la aplicación y la base de datos que permitía que las claves de API caducadas siguieran siendo válidas.
La inteligencia de vanguardia se encarece rápidamente
Mythos parte de los 10 $ por millón de tokens de entrada y 50 $ por millón de tokens de salida. Esto se acumula rápidamente cuando una revisión se expande en cientos de trayectorias de agentes a lo largo de un gran repositorio.
La dificultad radica en que las auditorías de código basadas en agentes no tienen una cantidad fija de trabajo. Dependiendo de factores como el tamaño del repositorio y la complejidad de la aplicación, el número de pistas a seguir y el razonamiento requerido tienden a variar de un repositorio a otro.
Claude Security deja esta variabilidad en tus manos. Los usuarios operan a ciegas porque Claude Security no proporciona el coste del escaneo hasta que la ejecución ha finalizado. Por lo tanto, cuando se asienta el polvo, puedes terminar con un coste mucho mayor del esperado.
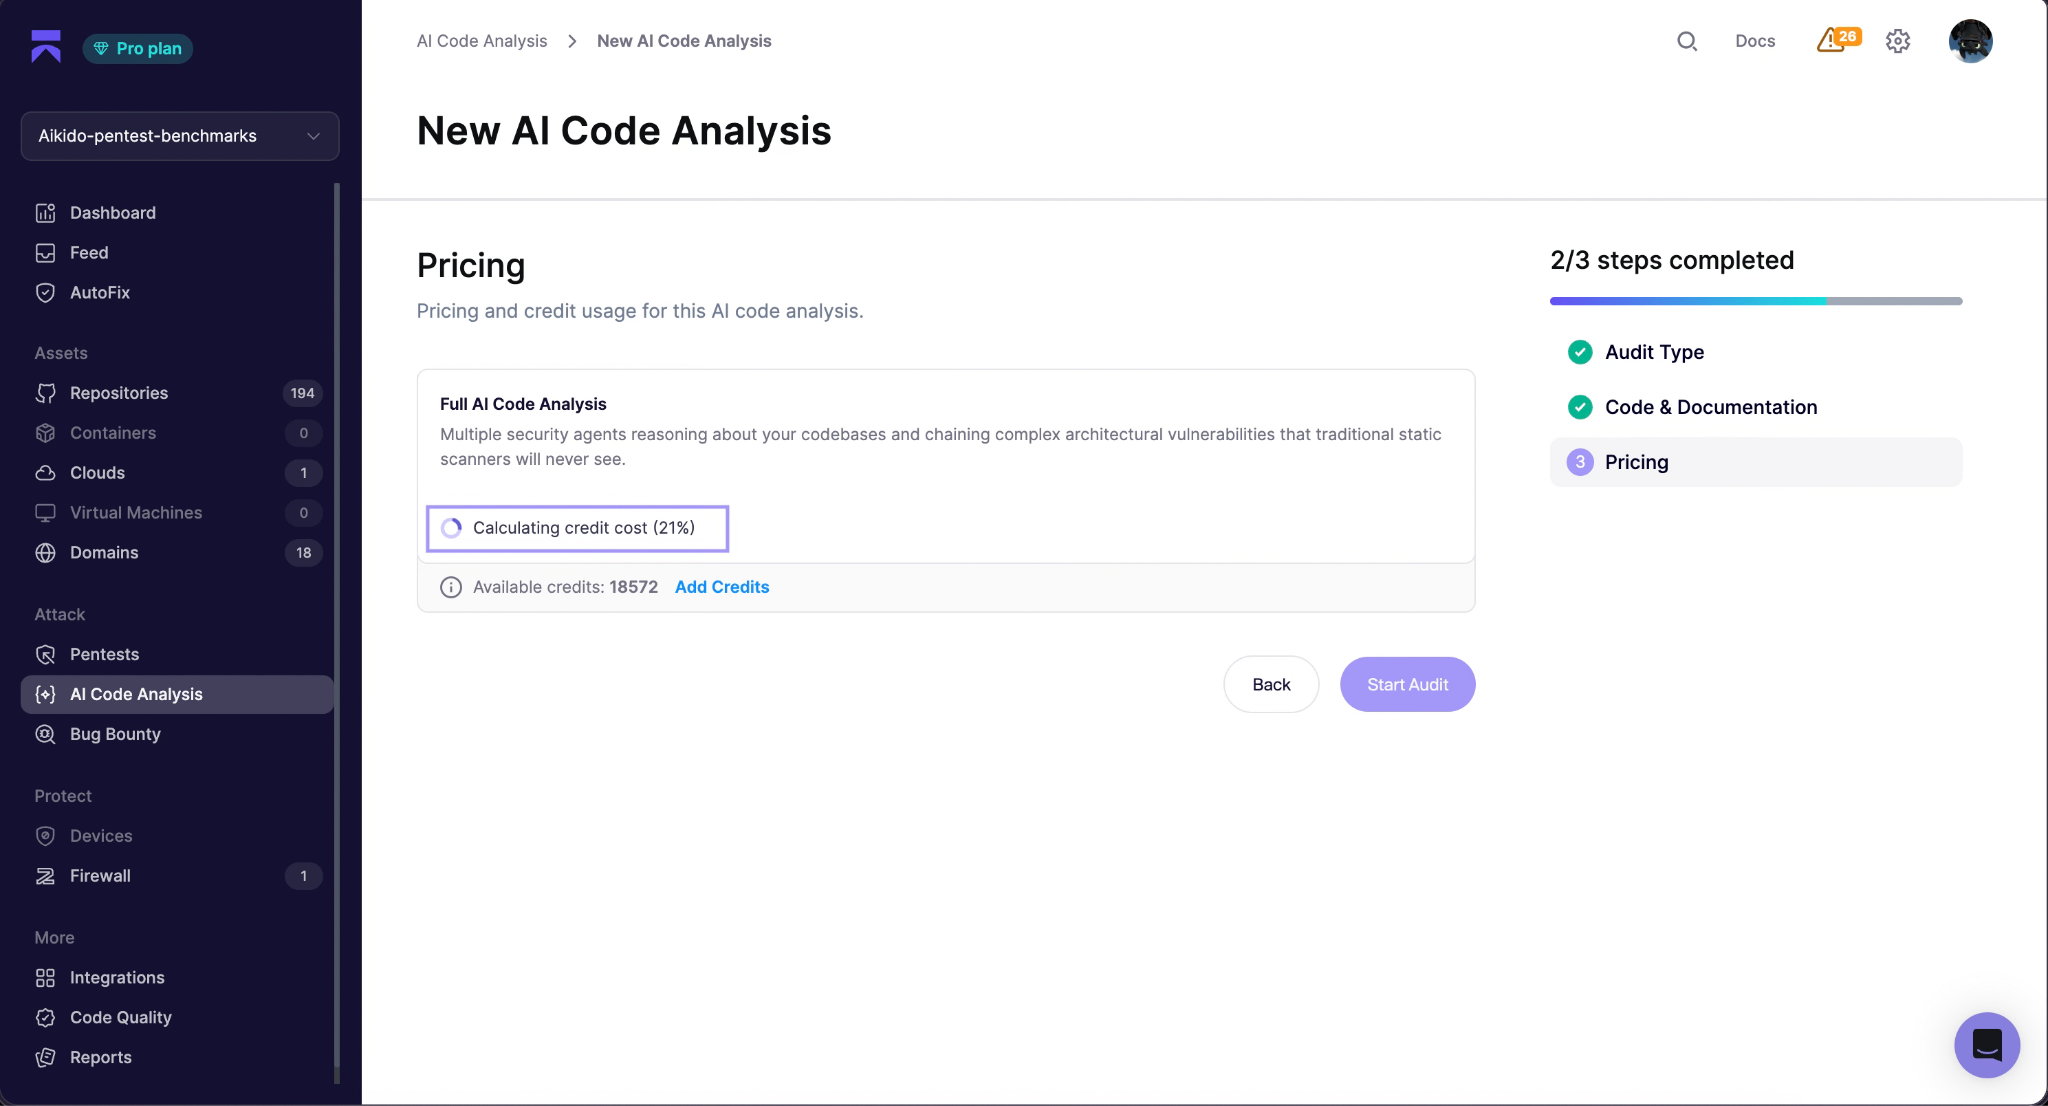
Aikido toma un camino diferente. Asumimos esa incertidumbre por ti. Antes de que comience el escaneo, estimamos dinámicamente su coste a partir del tamaño del repositorio, el código revisable y la complejidad, y mostramos dicha estimación al usuario.
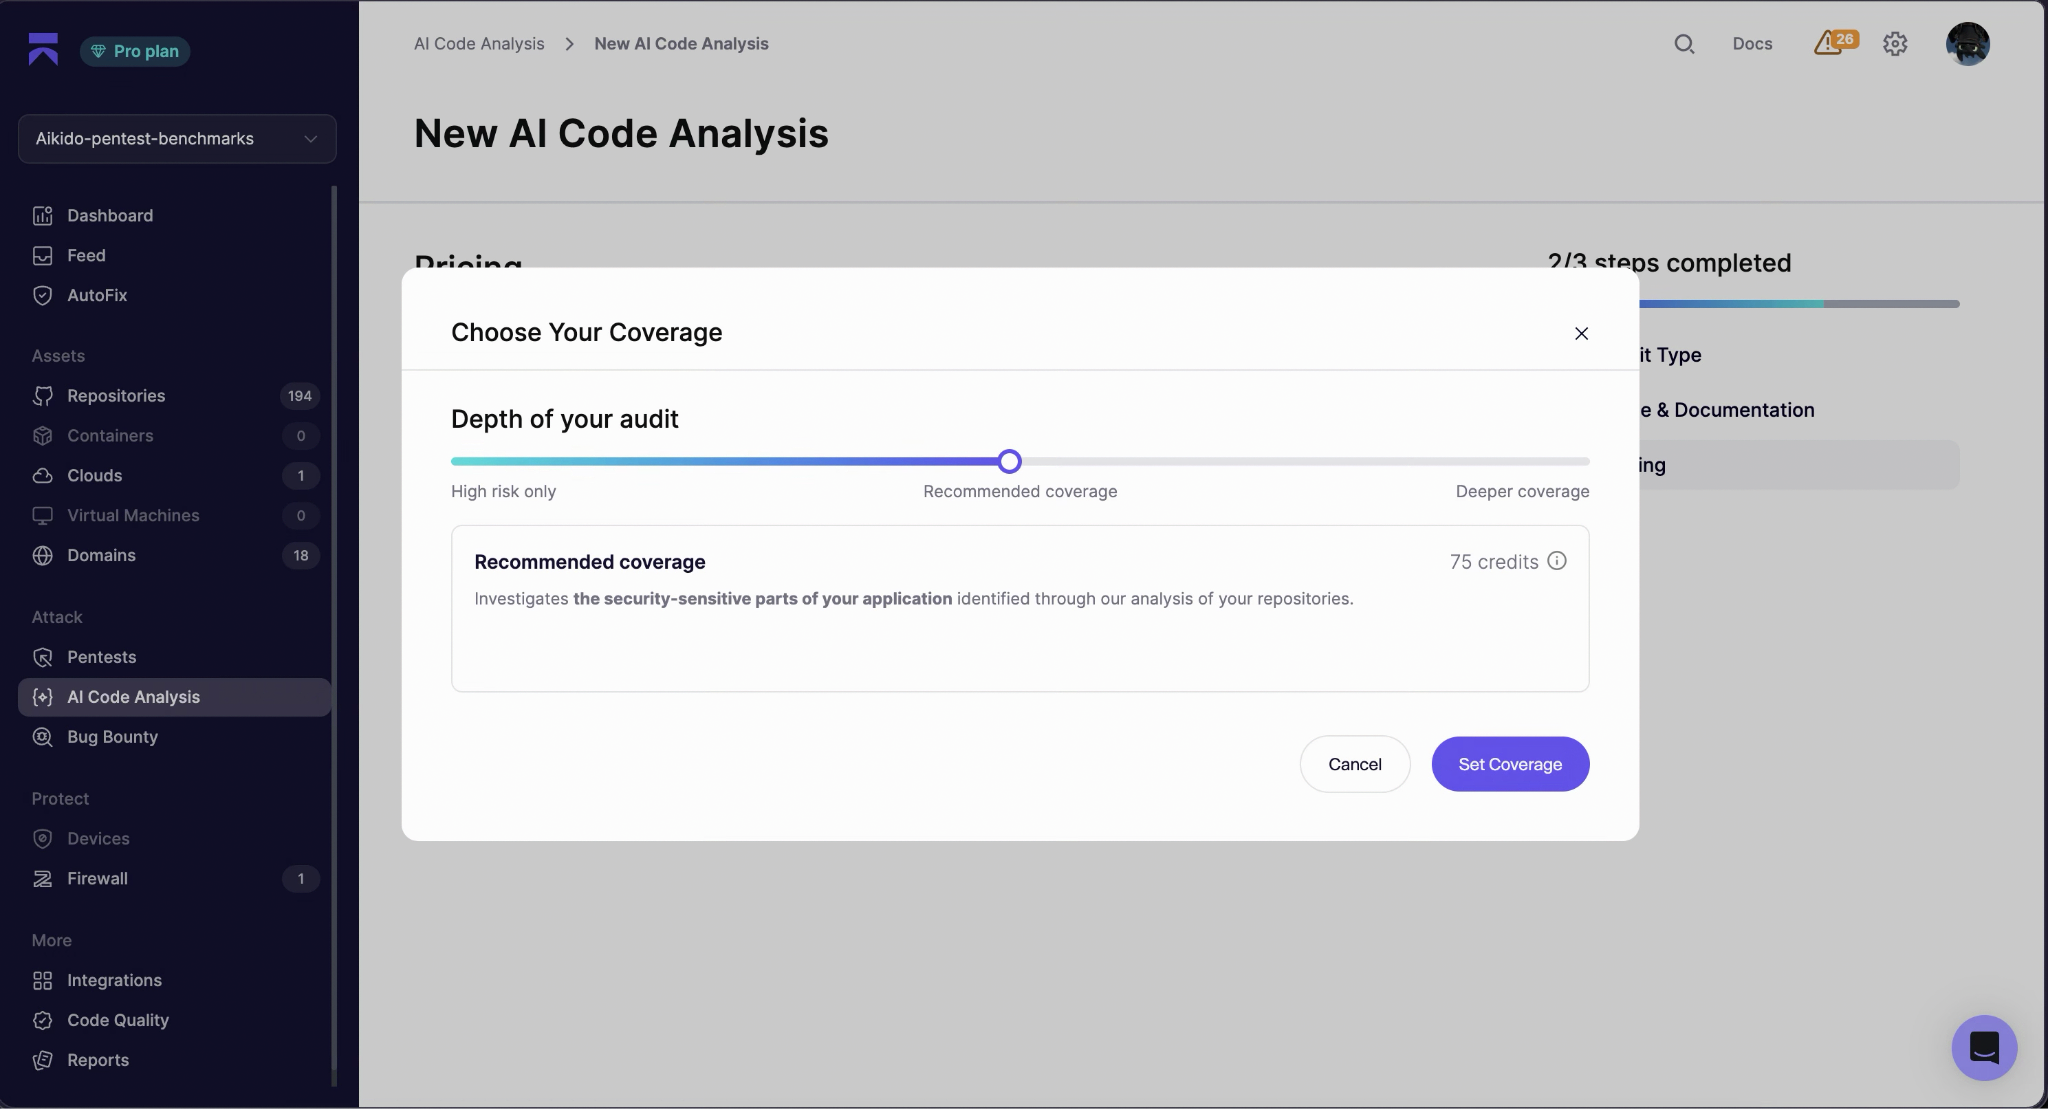
Como usuario, puedes aumentar o disminuir el nivel de cobertura para adaptarlo a esa estimación antes de comprometerte con ella. Nuestra ejecución en el repositorio de pruebas te habría costado 75 $ a la profundidad recomendada, mientras que Claude Security habría costado una tarifa fija de 157,06 $.
Y si consideras que el repositorio merece una cobertura aún más intensiva que la que hemos estimado automáticamente, tienes la libertad de aumentarla.
En nuestra ejecución con Claude Security, no se proporcionó ninguna estimación de coste de antemano, y el total solo quedó claro una vez finalizado el escaneo.
El repositorio que utilizamos para el escaneo tiene unas 15 000 líneas de código. No tener la opción de ver una estimación de coste por adelantado o ajustar el nivel de esfuerzo del análisis a tu presupuesto es manejable en un repositorio de este tamaño. Sin embargo, se convierte en un problema mucho mayor a medida que los costes de búsqueda de vulnerabilidades aumentan con el tamaño del repositorio, el tipo de aplicación y la complejidad del pipeline.
Si aplicas un modelo costoso a un monorepo o lo ejecutas en cada pull request, la ausencia de una estimación previa al escaneo puede dejarte con costes sustanciales mucho mayores de los esperados.
Qué significa esto
Llevamos tiempo argumentando que el diseño del arnés determina los resultados de seguridad más que el modelo que hay debajo. Este benchmark nos ofrece un primer vistazo a una comparativa directa al probar Mythos 5 y Codex Security frente a Code Security Audit en los mismos repositorios, demostrando que el arnés sigue marcando la diferencia.
Por supuesto, un benchmark no zanja el debate, pero sí aporta pruebas de que la premisa de que «el arnés prima sobre el modelo» ya no se sostiene solo en afirmaciones.


