

Hoy presentamos Altar, nuestro primer modelo de seguridad de pesos abiertos, diseñado para llevar una seguridad defensiva de vanguardia a una infraestructura bajo tu propio control.
Dimos nuestro primer paso hacia la inteligencia de seguridad soberana con nuestro dispositivo de pentesting autónomo Aikido Machine, que se ejecuta íntegramente dentro de la infraestructura del propio cliente, incluso en entornos completamente aislados (air-gapped). Los equipos con normativas estrictas sobre mantener el código de manera interna pueden detectar, explotar y validar continuamente vulnerabilidades en toda su superficie de ataque sin incumplir esas reglas.
Altar dota a Aikido Machine de una IA avanzada que defiende sin enviar el contexto más sensible de una organización a un servicio de inferencia de terceros.
Para lograrlo, necesitábamos superar la brecha de despliegue. La mayoría de los modelos de pesos abiertos capaces siguen siendo difíciles de desplegar a escala de producción sin comprometer la capacidad de razonamiento de los modelos de vanguardia.
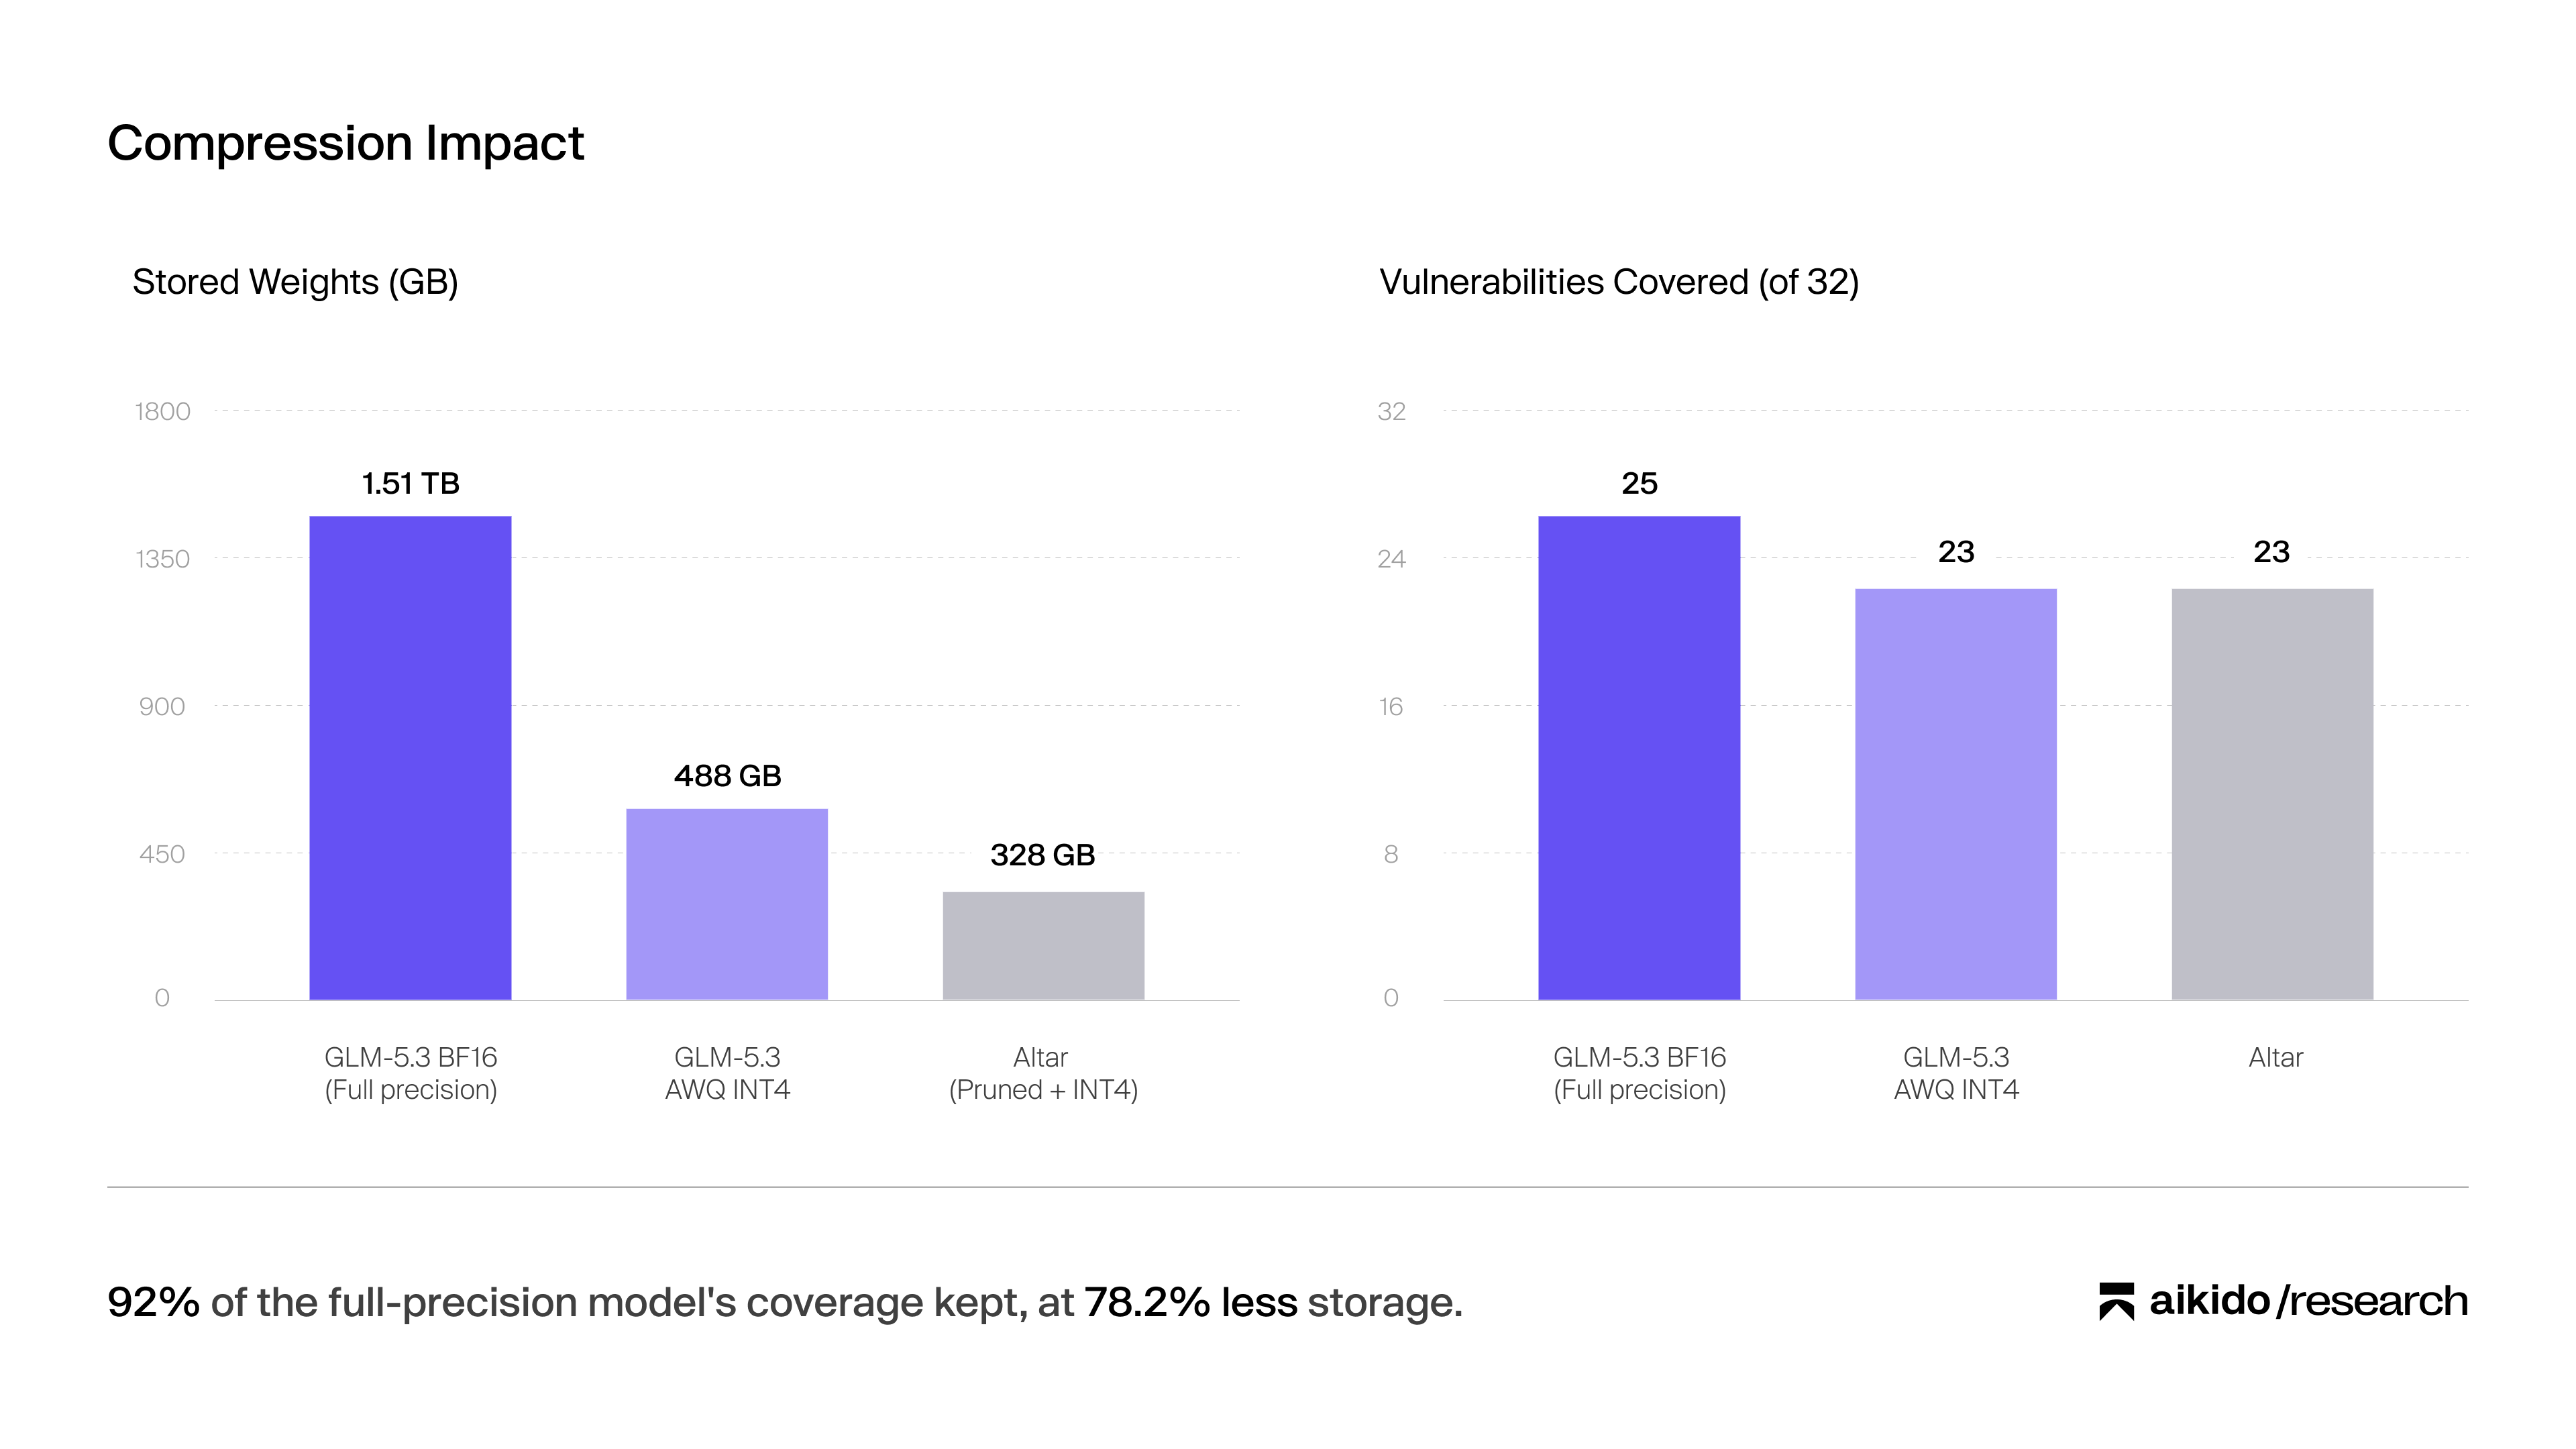
Empezamos con GLM-5.3, uno de los modelos más potentes en nuestras evaluaciones de seguridad. El modelo completo ocupa 1,51 TB; la cuantización lo reduce a 488 GB, y nuestro proceso de poda experta lo disminuye aún más hasta los 328 GB, preservando al mismo tiempo la mayor parte de la capacidad de razonamiento del modelo original.
Explicación de la brecha entre los modelos de vanguardia y los de pesos abiertos
Los modelos cerrados de vanguardia se ejecutan en la infraestructura de terceros
Utilizar uno significa que tu código fuente, tu documentación de arquitectura interna y tus hallazgos pendientes de corrección abandonan tu red. Para un banco que opera bajo una normativa de residencia de datos, un grupo hospitalario sujeto a estrictas reglas de procesamiento de datos o un operador industrial cuyo entorno de tecnología operativa (OT) no tiene ninguna ruta hacia internet, esta no es una concesión que se le permita hacer.
La brecha de despliegue
Servir un modelo como GLM 5.3 a precisión completa requiere cientos de gigabytes de memoria unificada y ofrece una velocidad de inferencia limitada al atender conversaciones paralelas con amplias ventanas de contexto. En términos humanos, son enormes.
Esas demandas de recursos se deben, en parte, a cómo están construidos estos modelos. Muchos de los modelos más potentes actuales utilizan arquitecturas de mezcla de expertos (mixture-of-experts). Estos modelos se componen de una multitud de pequeñas redes neuronales especializadas, cada una llamada experto. Solo un pequeño número de expertos está activo para cada token, mientras que el conjunto completo de expertos debe almacenarse y mantenerse en servicio. Esto implica asumir un coste significativo de memoria e infraestructura para una capacidad que quizás aporte poco a la carga de trabajo que realmente estás ejecutando.
Las tareas de seguridad, como revisar código en busca de vulnerabilidades, proponer parches y ejecutar una prueba de penetración, solo recurren a una pequeña parte de ese conjunto de expertos. Sin embargo, el coste de memoria no se reduce proporcionalmente: cada solicitud sigue teniendo que cargar el modelo completo, sea o no relevante para la tarea.
Si a esto le sumamos los agentes, el uso del contexto se dispara, lo que satura la memoria y hace que los agentes compitan entre sí por espacio. Cada uno mantiene un registro en tiempo real de todo lo que ha visto y hecho, y ese registro se almacena en la memoria de la GPU junto con el propio modelo, creciendo a medida que la investigación se prolonga y multiplicándose por cada investigación que se ejecuta en paralelo.
Por eso el tamaño del modelo importa aquí: el modelo y todo ese contexto en expansión consumen la misma reserva fija de memoria, de modo que un mayor tamaño de uno deja menos espacio para el otro. El objetivo es lograr que un modelo de vanguardia sea más eficiente de operar para una carga de trabajo específica, preservando las capacidades importantes y liberando capacidad para todo lo que se ejecuta en paralelo.
¿Qué podemos eliminar sin perder lo que importa?
La gran carga que supone incluir a tantos expertos en un modelo se puede convertir en una ventaja con las técnicas adecuadas. Con el fin de minimizar el tamaño de los modelos de pesos abiertos en un contexto de seguridad basada en agentes, manteniendo al mismo tiempo una gran precisión, utilizamos la cuantización y la poda.
La poda de expertos elimina a algunos de los expertos del modelo, normalmente suprimiendo bloques enteros de pesos de expertos y ajustando el modelo para que cada token solo elija entre los que quedan. La eliminación en sí es mecánica. Decidir qué expertos eliminar es la parte difícil, y la pérdida puede ser desigual: un modelo más pequeño puede mantener un fuerte rendimiento en programación y perder gran parte de su capacidad para comprender un lenguaje natural en particular. Esto puede dejarlo incapacitado para interpretar de forma fiable la documentación, las reglas de negocio o las características de una aplicación descritas en ese idioma.
Para decidir qué conservar, empezamos por los datos más naturales: los rastros de nuestro entorno de pruebas de pentesting ejecutando benchmarks internos. Estos capturan el código, las llamadas a herramientas y las respuestas con las que trabajan los agentes durante un pentest completo, lo que nos proporciona entradas representativas para guiar la selección de expertos. Nunca se utilizaron datos de clientes.
Este paso de calibración nos proporciona una base específica para la carga de trabajo en la selección de expertos, sin necesidad de entrenar nuevas habilidades en el modelo.
Los rastros del entorno de pruebas cubrían la carga de trabajo técnica. También necesitábamos preservar la comprensión del lenguaje: investigar una aplicación implica entender sus características, reglas de negocio y flujos de trabajo previstos, incluso cuando su documentación o interfaz están en francés, holandés u otro idioma. Por lo tanto, añadimos texto multilingüe para ayudar a preservar esas capacidades durante la poda.
La selección importa tanto como el tamaño
Existen muchas técnicas de poda para reducir la huella de los LLM, por lo que decidimos optar por una técnica capaz de preservar el rendimiento para nuestros casos de uso: Cerebras REAP (Router-weighted Expert Activation Pruning). Utilizamos la puntuación de contribución de REAP junto con una estrategia de agregación que preserva el dominio, seleccionada a través de experimentos de fidelidad. Contar la frecuencia con la que se selecciona a un experto ofrece solo una parte de la imagen. REAP estima su contribución utilizando tanto la ponderación del enrutador como la magnitud de la salida del experto.
También examinamos las contribuciones en diferentes grupos de ejemplos. De lo contrario, una capacidad importante para una carga de trabajo menos común podría perderse en un promedio general. Las capacidades de ciberseguridad, programación y lenguaje se distribuyen entre los expertos; no existe un conjunto claramente etiquetado de «ciber-expertos» que conservar o descartar.
En el estudio de compresión de apoyo, los modelos que retenían el mismo número de expertos diferían sustancialmente en la fidelidad con la que sus salidas seguían al modelo de referencia. El tamaño por sí solo no determinaba qué sobrevivía.
De 1,51 TB a 328 GB
Logramos una reducción total del tamaño del modelo del 78,2 % en comparación con GLM 5.3 a precisión completa, y del 32,8 % en comparación con GLM 5.3 con una cuantización AWQ INT4. Altar conserva 168 de los 256 expertos enrutados originales en cada capa de expertos troncal, eliminando 88, es decir, el 34,4 % de ellos. El enrutador sigue seleccionando ocho por token, ahora a partir del banco más pequeño.
La otra parte de la reducción proviene de la cuantización. Los pesos de un modelo son los valores numéricos que aprende durante el entrenamiento. La cuantización almacena esos números con menos bits, sacrificando algo de precisión a cambio de unos pesos almacenados más pequeños. A diferencia de la poda, no elimina expertos.
Nuestro punto de control inicial utilizó AWQ para almacenar la mayoría de los pesos de los expertos en cuatro bits en lugar de los dieciséis del modelo BF16. AWQ utiliza información sobre la actividad del modelo en las entradas de ejemplo para limitar los errores introducidos por una menor precisión. Los valores intermedios producidos durante la inferencia, llamados activaciones, se mantienen en 16 bits; de ahí W4A16, o pesos de cuatro bits y activaciones de 16 bits. Algunos pesos también retienen una mayor precisión. A continuación, aplicamos la poda a este punto de control que ya estaba cuantizado.
La comparación de ambas representaciones principales muestra lo que aporta cada paso:
Esto representa un 78,2 % menos de almacenamiento que el modelo completo de 16 bits. En comparación con el modelo base ya cuantizado, la poda elimina otros 160 GB, lo que supone una reducción del 32,8 %.
El impacto de la compresión en las capacidades de identificación de vulnerabilidades
Previamente hemos creado un CVE benchmark interno que utilizamos para evaluar la capacidad de un modelo para identificar vulnerabilidades complejas del mundo real utilizando nuestro entorno de pruebas de análisis de código con IA: 32 vulnerabilidades conocidas en 30 repositorios, con tres ejecuciones por cada caso.
Ejecutamos Altar contra él. Altar promedió un 60,4% de recuperación por ejecución y redescubrió 23 de las 32 vulnerabilidades al menos una vez en tres ejecuciones.
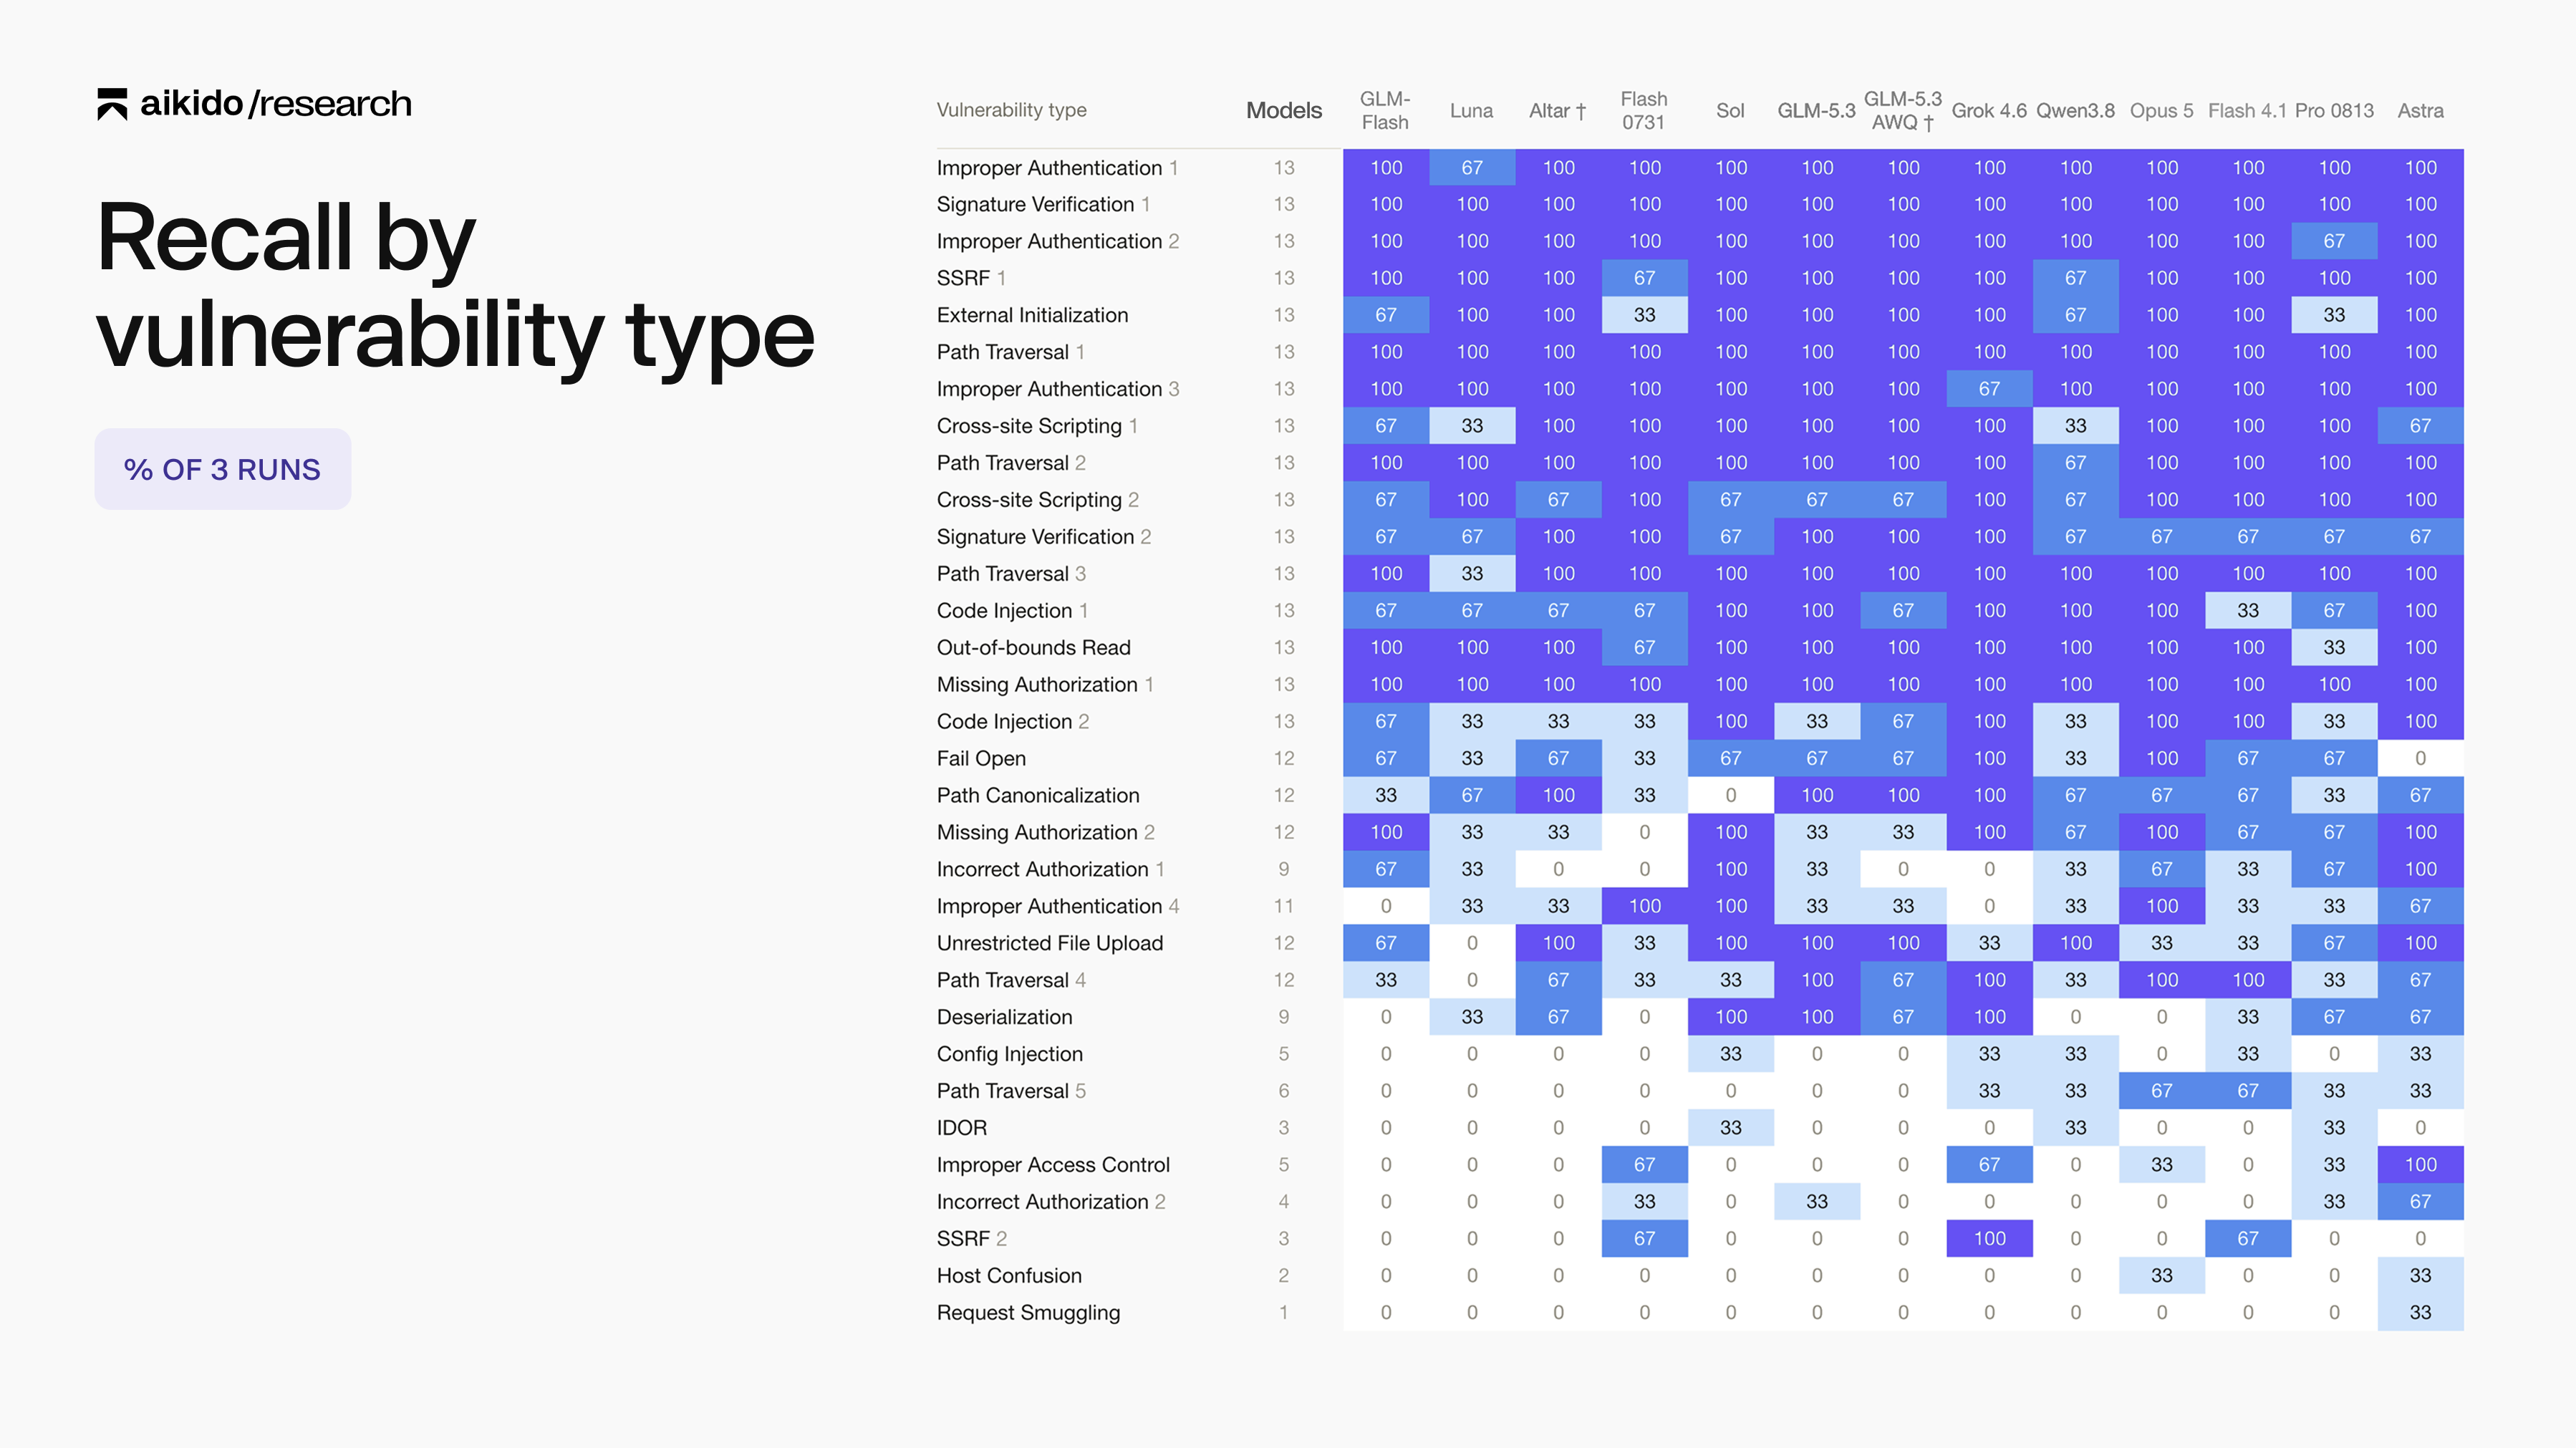
En comparación, el GLM-5.3 AWQ cuantizado promedió un 61,5% de recuperación y cubrió las mismas 23 vulnerabilidades. El modelo GLM-5.3 original a plena precisión promedió un 65,6% de recuperación y cubrió 25 de 32.
En otras palabras, reducir el punto de control (checkpoint) ya cuantizado de 488 GB a 328 GB, una reducción del 32,8% en los pesos almacenados, dio como resultado aproximadamente un punto porcentual menos de recuperación media en comparación con la línea base de AWQ, manteniendo toda su cobertura de vulnerabilidades. En comparación con el modelo original, Altar conservó 23 de sus 25 vulnerabilidades cubiertas (un 92%), con una disminución de 5,2 puntos porcentuales en la recuperación media. Eso es el 92% de la cobertura de vulnerabilidades del original conservada con un 33% menos de almacenamiento.
Ese es el compromiso que buscábamos: un modelo considerablemente más pequeño que preserva la mayor parte de la capacidad de seguridad del original.
Informamos sobre la recuperación media por ejecución de forma independiente a la cobertura en tres ejecuciones: encontrar una vulnerabilidad una vez es diferente a encontrarla de forma constante. Las ejecuciones completadas sin ningún hallazgo cuentan como fallos; las ejecuciones incompletas se informan por separado.
Esto mide el redescubrimiento dirigido de CVE dentro de un pipeline que utiliza otros modelos para las etapas circundantes. No mide el descubrimiento a ciegas en todo un código fuente (codebase), no ejecuta exploits para validar hallazgos ni evalúa la etapa de propuesta de corrección. Esos límites mantienen al benchmark diferenciado del flujo de trabajo de pentesting más amplio para cuyo soporte estamos diseñando Altar.
Además, implementamos Altar en nuestra flota de Aikido Machine inmediatamente después de completar estas evaluaciones. Poco después de la implementación, identificó una vulnerabilidad crítica válida durante un pentesting de producción de un cliente.
{{cta}}
Qué sigue
La idea subyacente es más amplia: la inteligencia de seguridad soberana debe ejecutarse dentro de cualquier entorno que proteja.
Altar es solo el principio. En cuanto a la compresión, estamos explorando formatos de menor número de bits como EXL3, lo que podría permitirnos conservar a más expertos, junto con optimizaciones adicionales de servicio para H200.
El siguiente paso es ir más allá de la compresión y adentrarse en el entrenamiento: afinar (fine-tuning) modelos para flujos de trabajo de seguridad, mejorar el uso de herramientas y el razonamiento a largo plazo, y construir un pipeline de autoaprendizaje guiado por nuestros benchmarks internos para orientar y dar forma a futuros modelos.
Ese trabajo se extenderá a la investigación de vulnerabilidades, el análisis de código, la remediación y otros flujos de trabajo de seguridad defensiva.
Aikido Labs existe para seguir impulsando esto: modelos que ganan capacidad con el tiempo sin perder la restricción que importa, es decir, que los defensores deben poder ejecutarlos por completo dentro de los entornos de cuya protección son responsables.
Gracias a Z.AI por GLM-5.3, a Cerebras por REAP, a cyanwiki por el modelo cuantizado y a 0xSero por el trabajo de compresión. El estudio de fidelidad y los planes de retención públicos, junto con el toolkit de poda (pruning), proporcionan más detalles técnicos sin publicar las conversaciones sin procesar de los agentes.
Los pesos de Altar están disponibles en la organización de Aikido. Altar se puede desplegar y poner en servicio cómodamente utilizando un nodo de 4-H200s y la última versión de vLLM. Descarga Altar para consultar la tarjeta del modelo (model card), la licencia, los flags de servicio y las instrucciones de despliegue.
¿Necesitas ayuda para ejecutarlo en tu propio entorno? Ponte en contacto con Ventas para hablar sobre el despliegue de Altar en tus instalaciones (on-prem).
El enfoque se está expandiendo a toda la línea de productos de Aikido, incluidos Aikido Attack (pentesting de IA), Code Security Audit y Deep PR Review.




